AIが生成したプルリクエストでテストが通っても、レビュー担当者が認可チェックの欠落を見つけることがあります。マージする前に、どの失敗が変更を止めるのか、誰が例外を承認できるのかを明確にする必要があります。
品質ゲートは、その問いに答えます。変更をマージする前に満たすべき要件を定め、それぞれの証拠をレビュー担当者が確認できる場所にまとめます。例外を承認する権限は、コードを書いたエージェント以外に持たせます。
ソフトウェア開発における品質ゲートとは
定義した基準と、先へ進めるかの判断
コードの品質ゲートは、変更をチームの受け入れ基準と照らし合わせるチェックポイントです。テストの成功、検出した脆弱性の上限、カバレッジの要件、指定したレビュー担当者の承認などを基準にできます。リポジトリや変更の種類に応じて、適用する条件を決めます。
ゲートは、それらの結果をリリースの判断につなげます。必須条件を満たさなければ、問題を修正するか、認められた例外手続きを取るまで変更を止めます。失敗を表示するだけのダッシュボードには、変更を止めるためのリポジトリやパイプラインのルールを組み合わせる必要があります。
SonarQubeの品質ゲートのドキュメントは、具体例を示しています。SonarQubeは分析メトリクスに対して条件を評価し、合格か不合格かを返します。チームはその結果を使ってCIパイプラインを失敗させたり、リポジトリとの連携を通じてプルリクエストのマージを防いだりできます。
AI生成コードでの具体例
エージェントが公開APIを変更するとします。チームのポリシーでは、互換性テストに合格することと、破壊的変更をドキュメントに記載することを必須としています。ゲートはマージ前に両方をチェックするため、コードがコンパイルできて単体テストが通っても、ドキュメントの更新がなければチェックは失敗します。
ルールは必ず具体的に書いてください。「公開エンドポイントの破壊的変更をプルリクエストの説明に記載する」というルールなら、レビュー担当者や自動チェックが評価する対象が明確になりますが、「良い変更であることを確認する」では明確になりません。
AIエージェントがコードを書くと何が変わるか
AI利用は増え、信頼は低下している
2025年のStack Overflow Developer Surveyでは、回答者の84%が開発工程でAIツールを利用中、または利用予定と答えました。2024年は76%でした。Stack Overflowは調査に伴う発表で、AI出力の正確さを信頼しないという回答が2024年の31%から2025年の46%へ増えたと報告しました。
調査発表で、Stack OverflowのCEO、Prashanth Chandrasekarは、「AIは強力なツールですが、誤情報の大きなリスクがあり、複雑さや関連性が不足する場合もあります」と述べています。
AIの出力を確認するレビュー担当者が読むコードの量も増えています。LinearBは、2026年に4,800チームの810万件のプルリクエストを分析し、AI支援を使ったプルリクエストの規模は、支援を使わないものの約2.5倍だったと報告しました。75パーセンタイルでは、支援なしの157行に対し、AI支援ありは400行を超えていました。LinearBが測定したのは変更の規模であり、欠陥率ではありません。そのため、このデータが示すのは、大きなプルリクエストに欠陥が多いことではなく、1回のレビューで確認するコードが増えることです。
レビューにはエージェントの説明以外の証拠も必要
エージェントは、プルリクエストを開く前に変更を計画して実装し、その後にテストと修正を行えます。エージェントが作業を説明すれば、提案した方法を理解する助けになりますが、その説明を要件、コード、テスト結果と照らし合わせて確認する必要があります。
作業を行うのがエージェントであっても、エージェントが生成した変更の責任は人にあります。課題、受け入れ基準、関連する実行記録、検証結果を、レビュー担当者が確認できるようにしてください。エージェントが自信を持って作業を説明していても、それが実装の正しさを証明すると考えてはいけません。
別の評価が必要な場面では、生成とは別に評価の工程を設けてください。Anthropicの効果的なエージェントを構築するための2024年のガイドは、あるLLM呼び出しが回答を生成し、別の呼び出しが評価するevaluator-optimizerワークフローを説明しています。それでも、別の呼び出しでレビューするモデルが、コードを書いたモデルと同じ間違いをする可能性はあります。そのため、チームが見つける必要のある欠陥を使って、レビューのプロセスをテストしてください。
品質ゲートとCI/CD、コードレビューの関係
CI/CDはチェックを実行し、その結果を適用する
CI/CDはソフトウェアをビルド、テスト、配信し、品質ゲートはそのワークフローの結果を使って、変更を先へ進められるかを判断します。必須のCIテストは、その失敗によってマージが止まるときにゲートの一部になります。
パイプラインは、テスト以外も実行できます。静的解析、シークレット検出、依存関係スキャン、ポリシーチェックはいずれも判断に利用できます。
それでも、ゲートが何を検証できるかは、設定したチェックと、そのチェックが調べる証拠に左右されます。CIが緑であることは、設定したチェックが通ったことを意味しますが、すべての要件がテストされたとは限りません。たとえば、テストスイートが認可ルールを見落とすことも、ドキュメントチェックの対象に該当エンドポイントが含まれていないために、未記載のAPI変更を見落とすこともあります。欠陥によってチェックの不足が明らかになったら、本来それを検出すべきだったテストやレビューチェックを拡充してください。
レビュー結果は、ポリシーが必須にしたときにゲートになる
人やAIのレビュー担当者は、問題を見つけ、トレードオフを評価します。リポジトリのルールは、必須の承認、レビュースレッドの解決、ステータスチェックを通じて、その結果をマージの許可につなげます。任意のコメントはフィードバックを提供する一方、必須の承認は変更を先へ進められるかを決めます。
自動レビュー担当者はコードを調べて結果を報告できますが、どの結果がマージを防ぐかはリポジトリのルールが決めます。そのため、レビューの設定と、強制するための設定の両方を必ず確認してください。
セキュリティ分析の結果も品質ゲートに利用でき、どのセキュリティ上の検出結果に修正や承認済みの例外が必要かは、チームのポリシーで決めます。セキュリティチェックが通っても、その基となる分析の限界は残ります。変更がアーキテクチャに適合し、正しい問題を解決するかどうかは、自動チェックの範囲外であり、システムを理解する人の判断が必要です。
AI生成コードの品質ゲートを信頼できる条件
独立したレビューと一貫した基準
レビュー担当者が要件、コード、テスト結果を確認できるようにし、承認の権限はコードを生成したエージェントの管理下に置かないでください。ベンダーを変えるだけでは独立性が成立しないため、生成とレビューの各工程が何を評価するのかを確認してください。同じベンダーを両方の工程で使うことも、両者がすべての盲点を共有すると証明するものではありません。
Codex、Claude Code、Cursor、開発者のどれが変更を作っても、同じ基準を適用してください。機密性の高い変更には、作成したツールにかかわらず、リスクに応じて厳しいチェックを選びます。
対応すべき結果の選別と、分かりやすい説明
進行を止める指摘は、変更を止める理由になる要件や欠陥に結び付け、小さなスタイルの好みは、チームが必須要件にしていない限り助言として扱ってください。そうしなければ、開発者は欠陥の修正よりも、好みの違いを議論することにレビューの時間を使います。
失敗ごとに、何が失敗したのか、証拠はどこにあるのか、どう解決するのかを示してください。変更したエンドポイントと不足している互換性の証拠を示すチェックなら、次の対応が分かりますが、「APIの変更を検出しました」だけでは、自分で問題を探す必要があります。
CodeRabbitのAI生成コードに対応する品質ゲートの構築ガイドは、これらのレビューの原則、設定、導入手順を説明しています。
品質ゲートを配置し、監査する方法
早い段階でフィードバックし、マージ前に強制する
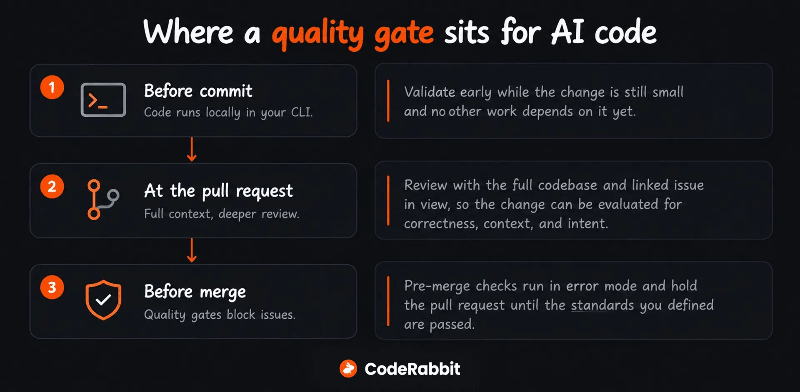
エージェント型SDLCでは、早期のローカルチェックが、開発者やエージェントによるプルリクエスト作成前の修正を助けます。続くプルリクエストのレビューでは、提案した変更、関連する要件、リポジトリの情報を取り込み、必須のマージチェックやデプロイチェックが該当する判断を強制します。失敗が進行を止める地点を特定し、最後のチェックが出荷する予定のリビジョンを評価することを確認してください。
CodeRabbitでは、Pre-Merge Checksを無効にするか、warningまたはerrorモードで実行できます。プルリクエストのWalkthroughコメントに報告される結果では、warningモードがデフォルトで、失敗を報告しますがマージは止めません。errorモードはAutomatic Approvalsと組み合わせて、失敗を修正するか明示的に例外を適用するまで承認を保留します。リポジトリのレビュールールでも、その承認を必須にする必要があります。
Walkthroughに報告されるPre-Merge Checksの結果がInconclusiveの場合、プルリクエストはブロックされません。一方、.coderabbit/pre-merge-checks/ディレクトリで定義され、GitHub Check Runsとして報告されるチェックは、結果がInconclusiveの場合にaction_requiredを返し、リポジトリがそのチェックを必須にしていればマージをブロックします。どちらの場合も、証拠が不足しているときに、マージの前に誰が確認するかを決めてください。
現在の設定が実際に止めるものを検証する
既存のルールを1つ選び、文書のポリシーからマージの判断までを追ってください。次に、そのルールに意図的に違反するテスト用のプルリクエストを開き、想定したチェックが失敗して変更を止めることを確認します。違反を修正したら、変更が通ることを確かめてください。誰が結果を上書きでき、どこに例外が表示されるかも確認しておくと役立ちます。
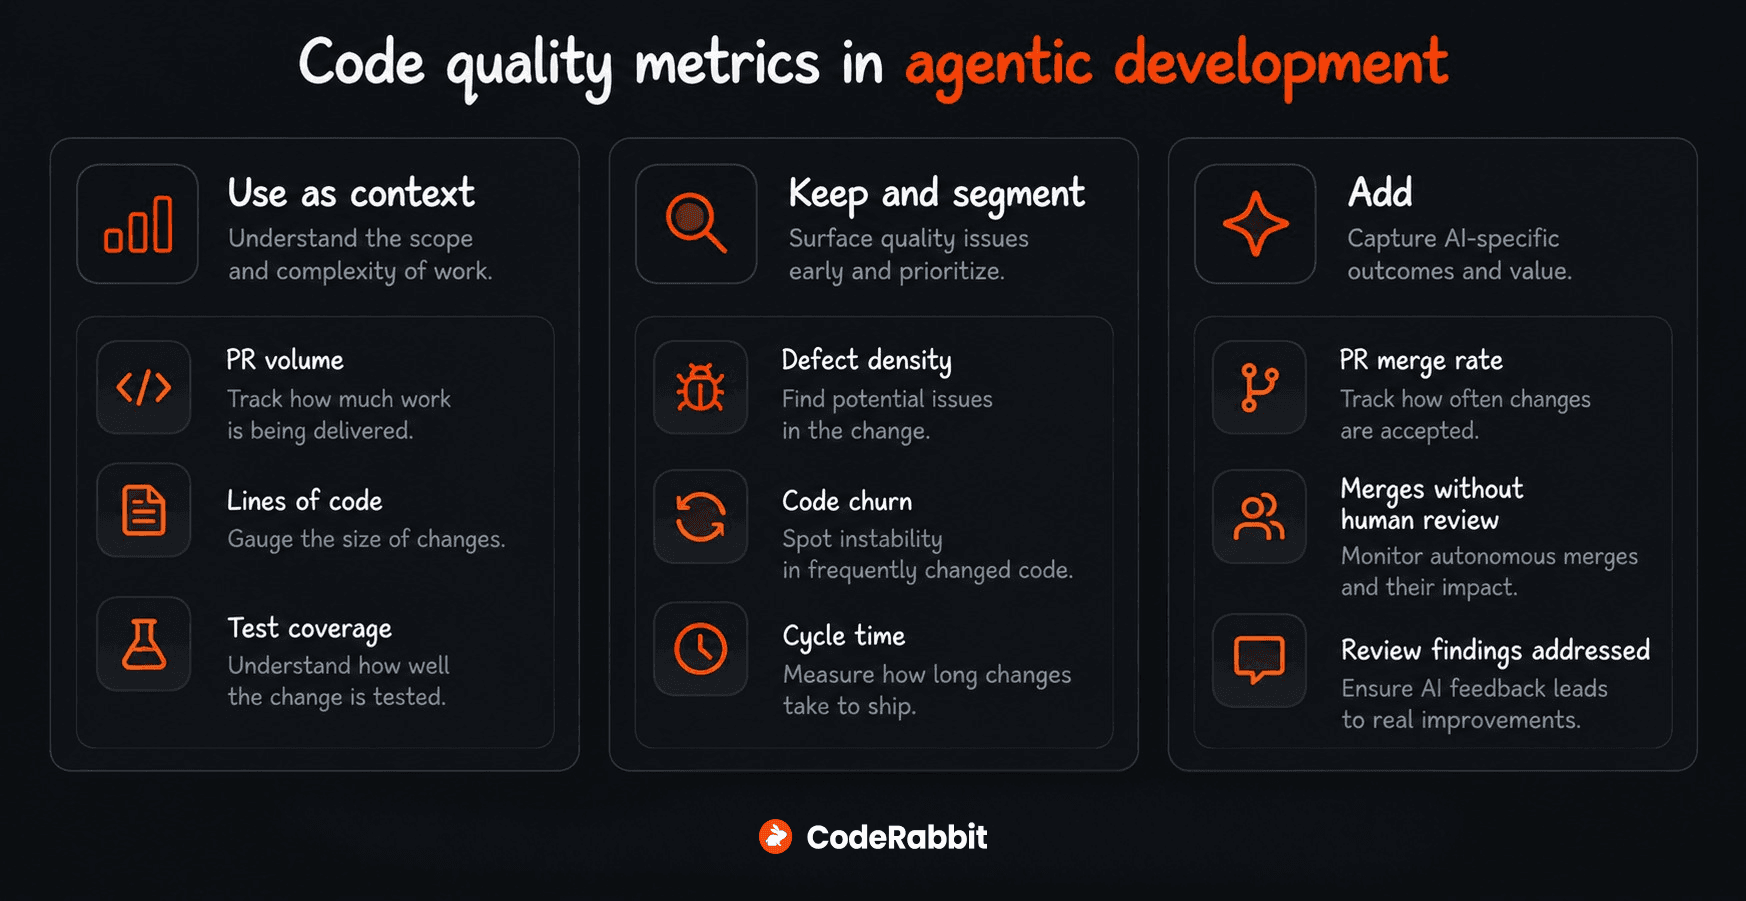
マージ前に見つかった問題だけでなく、マージ後に流出した欠陥も追跡してください。エージェント型開発のコード品質メトリクスでは、レビューのシグナルを欠陥密度やコードの変更頻度につなげる方法を説明しています。
次のプルリクエストでCodeRabbitを試し、その検出結果と、チームがすでに強制している要件を比較してください。