チームがAIコーディングエージェントを使うようになると、エンジニアリングダッシュボードの数値は解釈が難しくなります。プルリクエスト(PR)の増加は生産性の向上に見えても、それだけでは価値の提供が増えたのか、レビュアーや保守担当者の作業が増えたのかは分かりません。
問題は、ダッシュボードが何を測定しているかにあります。多くのコード品質指標は、人間がコードを書くことを前提に作られています。人間が書いた変更、AI支援による変更、エージェントがすべて生成した変更を一括して集計すると、特定の種類の変更が多くのレビューや保守作業を生んでいても、全体の数値は健全に見える場合があります。
22,000人の開発者を対象としたFaros AIの2026年レポートは、各組織でAI導入が最も少なかった時期と最も多かった時期の指標を比較しています。PR当たりのインシデント数は最大242.7%増加し、マージされたコードの追加行数に対する削除行数の四半期比率は、AI導入が多い時期には少ない時期より861%高くなりました。レビューなしでマージされたPRも31.3%増加しています。これらの変化は、従来の測定方法だけでは本番環境で起きていることを明確に捉えにくくなっていることを示しています。
この環境では、ソフトウェアの品質を測る方法を見直す必要があります。成果を反映する指標を維持し、投入量を示す指標の解釈を見直し、エージェントが生成した変更が適切にレビューされ、マージ後も安定しているかを示す指標を追加しましょう。
単独では判断を誤らせやすくなった指標
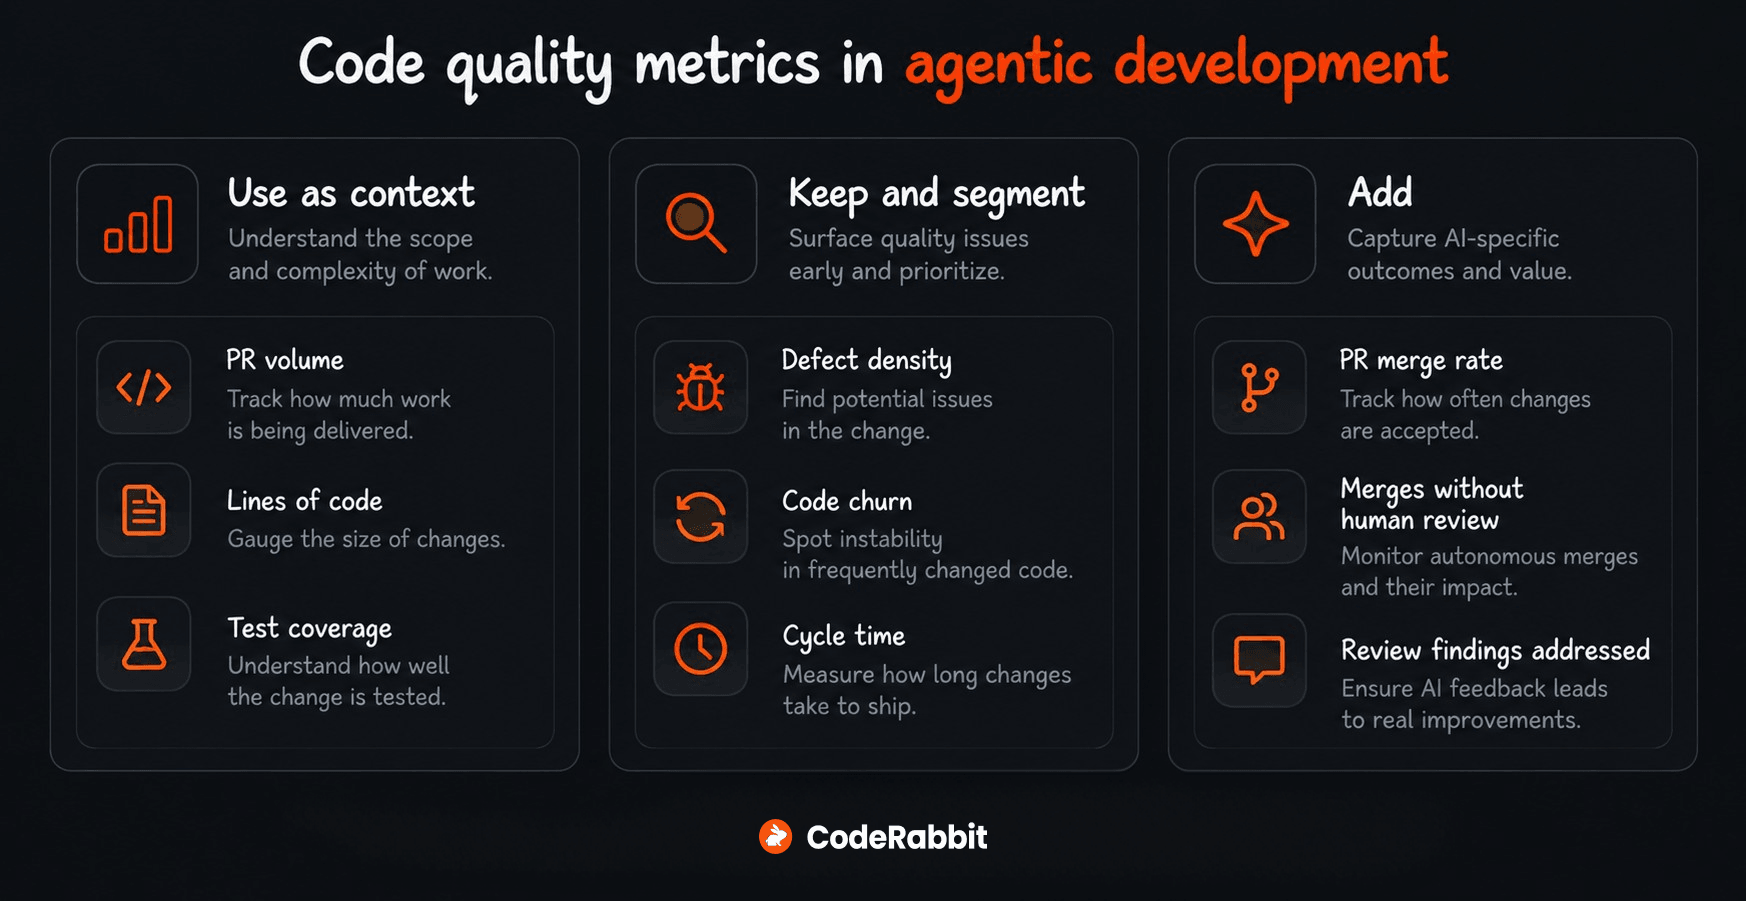
PR数とコード行数は出力量を示しますが、品質は示しません。テストカバレッジが答えるのは、テストでコードのどの程度が実行されたかという別の問いです。いずれも補助情報として扱い、レビュー中とマージ後に起きたことと組み合わせてください。
1. PR数
PR数は、チームが提案した変更の数を示します。
重要な理由: 以前はPR数の増加を開発活動の活発さと結び付けることが多くありました。今は、レビュアーが処理できる速度を超えてエージェントがPRを作成できます。PR数の増加は、レビュー待ちの増加や、採用されずにクローズされる変更の増加を意味する場合もあります。
測定方法: 固定した集計期間に作成されたPRを数え、変更の作成方法別に分けます。作成から30日以内にマージされた割合と併せて確認してください。
比較基準: 同じリポジトリの過去の期間と比較します。PR数が増えているのに30日以内のマージ率が下がっている場合は、出力の増加が採用される成果につながっているかを調べましょう。
2. コード行数
コード行数は、追加、変更、削除されたコードの量を表します。従来、開発者の出力量を大まかに測るために使われてきました。
重要な理由: AIエージェントは数秒で数百行を生成できます。大きな差分に価値のある実装が含まれていても、その大きさだけでは品質や保守性は判断できません。More Code, Less Reuseの研究では、エージェント作成のPRは人間のPRより既存コードを再利用する機会を逃しやすく、冗長なコードを多く含むことが分かりました。
測定方法: PRごとに追加行と削除行を別々に記録します。大きな変更を進捗とみなす前に、既存の設計に合い、既存コンポーネントを活用し、不必要にコードの複雑さを増やしていないかを確認してください。
比較基準: 同じリポジトリで、範囲が似た変更を比較します。開発者に行数の目標を課すのではなく、通常より大きな差分を詳しくレビューするきっかけとして使いましょう。
3. テストカバレッジ
テストカバレッジ(コードカバレッジ)は、テスト中にコードのどの程度が実行されるかを示します。
重要な理由: カバレッジは、正しい業務上の振る舞いを確認するテストと組み合わせて初めて役立ちます。実装とテストが同じ誤った前提に基づいていれば、要件を誤解したまま高いカバレッジを達成してしまいます。
測定方法: カバレッジレポートで未テストの経路を特定します。その上でアサーションを読み、重要な失敗ケースを検証しているかを確認してください。期待する振る舞いが製品要件と一致することも、レビュアーが確認する必要があります。
比較基準: リポジトリのカバレッジ基準値を使って低下を検出し、変更箇所のリスクに応じて期待値を設定します。目標の割合を満たすだけでは、業務上の振る舞いを正しくテストできているとは限りません。
今も重要な指標
欠陥密度、コードチャーン、サイクルタイムは、変更が採用された後に何が起きるかを示すため、今も有用です。人間による変更、AI支援による変更、完全にエージェントが生成した変更をまとめると大きな差が隠れるため、作成方法別に比較してください。
1. 欠陥密度
欠陥密度は、変更されたコード量に対する確認済み欠陥の数で、一般に1,000行当たりの数で表します。
重要な理由: 欠陥率が上がらなくても、変更量が増えれば欠陥数は増える可能性があります。欠陥密度は変更量を考慮するため、単純な欠陥数だけに注目せず、異なる作成方法の変更を比較できます。
測定方法: 対象の変更に関連付けられた確認済み欠陥数を変更行数で割り、1,000を掛けます。変更行数が0の場合は欠陥密度を「該当なし」とし、確認済み欠陥数を別に報告します。エージェント生成コードを開発者が編集したPRは、編集が小さくてもAI支援による変更と分類します。各PRのマージ後、90日などの同じ固定期間内に確認された欠陥を数え、観測期間全体が経過したPRだけを対象にします。作成方法にかかわらず同じ期間を適用し、欠陥の原因がエージェントか開発者かは推測しないでください。
比較基準: 同じリポジトリの過去の欠陥密度や、リスクが近い変更と比較します。全体の率が低下していても重大な欠陥が増えていないかを把握できるよう、重大度を分けて表示しましょう。
2. コードチャーン
コードチャーンは、最近追加または変更されたコードが、一定期間内にどの程度書き換えられたり削除されたりするかを示します。期間には14日や30日がよく使われます。
重要な理由: 採用後に多くの追加作業が必要になる変更を特定できます。高いチャーンは、要件変更や意図的なリファクタリングを反映する場合もあります。エージェント生成の変更に集中している場合は、文脈の不足や要件の誤解も考えられます。エージェントの認識のずれを分析した記事では、こうした不足がレビュー中のプロンプトのやり直しや書き直しにつながる仕組みを説明しています。
測定方法: 最近追加または変更された行のうち、選んだ期間内に書き換えられたり削除されたりした割合を追跡します。生成された変更と人間が作成した変更を同じ期間で比較してください。各行に選んだ観測期間全体を確保し、作成方法別に比較する前に、期間が経過していない行を対象から外してください。
比較基準: リポジトリの過去のチャーン率を基準に、種類が似た作業を比較します。計画されたリファクタリングや要件変更を考慮しながら、継続的な増加を調べましょう。
3. サイクルタイム
サイクルタイムは、変更の最初のコミットからデプロイまでの時間を測ります。
重要な理由: 多くのエージェント型ワークフローでは、コーディングが独立した工程ではなくなっています。エージェントは、開発者の指示を受けながら、実装、テスト、修正を連続したループで行います。そのため、実装期間が短くなっても、継続的なレビューや修正の作業が見えにくくなることがあります。
測定方法: 最初のコミットからPR作成、PR作成からレビュアーの着手、着手から承認までを記録します。承認からデプロイまでは別に測定してください。レビュアーの着手や承認なしでマージされた変更では、それらのイベントを必要とする段階を「該当なし」とします。最初のコミットからデプロイまでの時間は、全体のサイクルタイムに含めてください。
比較基準: 中央値と時間のかかった変更をリポジトリの基準値と比較します。実装の高速化に伴って、レビューやデプロイの待ち時間が増えていないかを各段階で調べましょう。
エージェント型開発チームが追加すべき指標
PRマージ率は、提案した作業がどれだけ採用されたかを示します。人間によるレビューと指摘への対応を追跡すれば、コードベースに入る前に変更がどう確認されているかを評価できます。
1. PRマージ率
PRマージ率は、作成されたPRのうち、30日などの一定期間内にマージされた割合です。
重要な理由: PR数と、採用された作業を結び付けます。エージェント生成のPRが増える一方でマージ率が下がっている場合は、採用される変更を増やさずにレビュー負荷だけを増やしている可能性があります。
測定方法: PRを作成時期別にまとめ、作成から30日以内にマージされた割合を計算します。各PRに観測期間全体を確保し、作成方法別に集計してください。
比較基準: 同じリポジトリの同等のPR群を比較します。継続的な低下と、却下や遅延の理由を調べてください。マージ数の増加に意味があるのは、チームの品質基準を満たしている場合だけです。
2. 人間のレビューなしのマージ
人間によるレビューや承認の記録なしでマージされたPRの割合を測ります。
重要な理由: 人間の直接の確認なしにコードベースに入るコード量が分かります。エージェントがより多く、より大きな変更を提案する中でこの割合が増えた場合は、レビュー需要が対応能力を超えている可能性があります。一方、低リスクの自動変更について人間の承認を意図的に不要としているチームもあります。
測定方法: 集計期間中に人間のレビュー記録なしでマージされたPR数を全マージPR数で割り、100を掛けます。リポジトリと変更リスク別に結果を分けてください。
比較基準: チームのレビューポリシーを基準にします。人間の承認が必要な変更では、未レビューのマージをゼロにすることが目標です。承認済みの自動化がレビューの抜けを隠さないよう、別に追跡しましょう。
3. 変更当たりのレビュー指摘数と対応率
変更当たりのレビュー指摘数は、マージ前に発見された実質的な問題の数です。対応率は、対処可能な指摘のうち対応するコード変更が行われた割合を示します。
重要な理由: この2つを組み合わせると、変更が生むフィードバック量と、それにチームが対応しているかが分かります。178のリポジトリにおける22,000件以上のレビューコメントを対象とした研究では、簡潔で具体的かつ関連コードに結び付いたコメントほど、コード変更につながりやすいことが分かりました。
測定方法: 実質的な指摘をPRごとに数え、作成方法と重大度で分けます。対応する修正が行われた指摘数を、対処可能な全指摘数で割って対応率を計算します。ステータスメッセージや重複は除外してください。
比較基準: 同じレビュールールの下で、リポジトリの基準値と比較します。指摘数の増加は、提出された変更の品質低下と、レビューの充実のどちらも反映し得ます。対応率が下がった場合は、見落とし、意見の相違、関連性の低い指摘がないかを確認しましょう。どちらの数値も、単独ではレビュー品質を証明しません。
CodeRabbitでレビュー品質のシグナルを把握する
CodeRabbitは、提案された変更をマージ前にレビューします。PR Walkthroughは、関連ファイルをまとめ、レビュー工数を推定し、リンクされた課題に照らして実装を確認します。Pre-Merge Checksを、自動化された品質ゲートとして設定することもできます。
ダッシュボードでは、変更ごとのレビュー指摘と、開発者がどの程度対応したかを追跡できます。PR当たりの平均レビューコメント数を表示し、CodeRabbitの指摘を重大度やカテゴリで分類します。コメント採用率は、CodeRabbitが完全に対応済みと検証した、または開発者が修正済みと確認したフィードバックを示します。
時間指標では、PRがレビュー可能になってから、最初の人間のレビュー、最終コミット、マージまでの時間が分かります。レビュアーの参加状況や平均レビュー回数と併せて、レビュー作業が滞っている箇所を特定できます。これらはレビュープロセスに焦点を当てた指標です。
ダッシュボードには、組み込みチェックとカスタムチェックの成功、失敗、判定不能を含むPre-Merge Checkの結果も表示されます。リポジトリ、ユーザー、チーム、期間で絞り込み、PR単位のデータをエクスポートして詳しく分析できます。PR指標の対象は、CodeRabbitがレビューし、選択期間中にマージされた変更です。
人間が作成した変更、AI支援による変更、完全にエージェントが生成した変更を比較するには、これらの記録とチームが収集する作成方法のラベルを組み合わせます。コードチャーンにはリポジトリ履歴を使い、欠陥密度には確認済み欠陥の記録を使います。こうして、レビュー中に発見された問題と、マージ後に必要になった保守作業を結び付けられます。
まとめ
エージェントがより多くのコードを書くようになるほど、コードレビュー中とデプロイ後に起きることを基に生産性とソフトウェア品質を測る必要があります。欠陥密度やコードチャーンなどの結果に注目し、出力量やカバレッジの数値は補助情報として使ってください。マージ前に、対処可能なレビュー指摘に対応したかも確認しましょう。
同じ集計期間とリポジトリの基準値を使って、作成方法別に比較します。CodeRabbitでレビュー活動とフィードバックへの対応を追跡し、リポジトリと欠陥のデータと組み合わせることで、コード生成の高速化がソフトウェアの信頼性向上につながっているかを確認できます。