チームがClaude CodeやCursorを使い始めると、リリースが速くなり、毎週レビューするプルリクエストも増えていることに気づきます。しかし半年後には、インシデントが増え、コードベースを把握しにくくなり、変更がシステムのほかの部分にどう影響するかを調べる時間が長くなっているかもしれません。
問題は、生成されたコードそのものだけでなく、人間が書いた変更を前提とするレビュープロセスが追いつかないことからも生じる可能性があります。AIコーディングエージェントは、エンジニアが確認するよりも速く判断を下せるため、チームは一部しか検証していないコードにも責任を負うことになります。
新しい機能が過去の選択に依存するようになると、元の判断を理解していなければ、問題の修正は難しくなり、コストも増えます。AI生成コードによる技術的負債を管理するには、コードの品質だけでなく、チームが何を理解し、何を文書化しているかも把握する必要があります。
AI生成コードの技術的負債が複利的に膨らむ理由
エージェントは、実装がアプリケーションのアーキテクチャにどう適合するかを知らなくても、チケットの要件を正しく実装できます。システムの別の場所ですでに解決済みの問題に独自の解決策を加え、設計上の負債を生むことがあります。
たとえば、顧客レコードをCSVファイルからアップロードする機能をエージェントが追加したとします。アプリにある既存の顧客データ検証を使わず、アップロード専用の検証処理を新たに作ります。機能はテストを通過してマージされますが、追加したルールが本当に必要かを誰も確認しません。
その後、あるエンジニアが古い顧客レコードも受け付けるようアップロード機能を更新し、別のエンジニアがアプリのほかの場所にある検証処理を変更します。時間がたつにつれ、2つの検証ルールは異なるものになります。ここで修正するには、どの変更が意図的で、それぞれのバージョンに何が依存しているのかを調べなければなりません。
再利用の問題には、実証的な裏付けもあります。More Code, Less Reuseでは、研究者がcrewAIリポジトリの617件のプルリクエストを調査しました。意味的な冗長性を測る指標では、エージェントが生成した変更のスコアは、人間による変更の1.87倍でした。また、CodeRabbitのオープンソースPR 470件の分析では、AIと共同で作成した変更は、人間だけで作成した変更と比べ、PRあたりのレビュー指摘数が約1.7倍でした。これらの数値は、それぞれ処理の重複とレビュー指摘数を測ったものです。
重複した処理がコードベースに入ると、新しい機能に取り組むエージェントが、それを標準的な実装方法と見なすかもしれません。変更が速く生成されるため、チームが元の問題に対処する前に、さらに多くの更新が進む可能性があります。その更新が重複した処理に依存していれば、更新のたびに修正は難しくなります。
AI支援開発における負債の形
AIコーディングエージェントを使う際、チームが直面しうる負債には次のようなものがあります。
1. 生成AIに起因する自己申告の技術的負債(GIST)
GISTは、研究者がコードコメントから見いだしたパターンを表します。開発者はAI支援で作成したコードを使いながら、その動作や正しさについて不確かさを示すことがよくありました。この研究では、公開されているPythonおよびJavaScriptリポジトリのLLMに言及したコメント6,540件のうち、81件がAIの関与と技術的負債の両方に言及していました。研究者はTODO、FIXME、HACKなどのキーワードを検索し、結果を手作業で確認しました。これらのコメントには、テストの先送りや未完了の変更などが含まれていました。
2. 認知的負債
Margaret-Anne StoreyのTriple Debt Modelは、認知的負債を、システムに関するチームの共通理解が時間とともに失われていくことと説明しています。Addy Osmaniの理解の負債(comprehension debt)は、個人がAIで生成できるコードと、その人が実際に理解している内容との隔たりに焦点を当てています。この個人の理解の隔たりが、Storeyの述べるチーム全体の問題につながることがあります。
コードベースが品質基準を満たしていても、チームが安全に変更するのに苦労することはあります。エンジニアは個々の関数を理解していても、リクエストがシステム内をどう流れるか、変更がどこに影響するかについて、明確な全体像を共有していないかもしれません。
3. 意図の負債
Storeyのモデルでは、意図の負債についても、システムの変化を方向づける目標や理由の記録が欠けたり、失われたりすることと説明しています。これには、将来の更新でも守る必要があるルールも含まれます。
コードが何をするかを理解するだけでは十分ではありません。チームは、その動作の背後にあるビジネス上の理由も知る必要があります。そうでなければ、誰かがタスクを完了しても、文書化されていないルールを意図せず破ってしまう可能性があります。
従来の負債管理では不十分になりうる理由
変更量がレビュー能力を上回る場合や、チームが注意を向けるべき対象を特定できていない場合、既存の負債管理の取り組みでは抜けが生じることがあります。
1. コードレビュー
AIエージェントが人間のレビュー速度を超えて変更を作ると、プルリクエストがたまり始めます。レビューなしでマージされるプルリクエストの増加も、チームが過負荷になっている兆候です。レビュー量への対処については、AI生成コードのコードレビューベストプラクティスをご覧ください。大きなバックログがあると、レビュアーは重要な疑問をすべて解消する前に変更を承認してしまうかもしれません。
2. 振り返り
振り返りでは、障害の背後にある前提を検討する必要があります。前提を問い直さずに目の前のバグだけを修正すると、同じ間違いが繰り返される可能性があります。
3. リファクタリングスプリント
リファクタリングスプリントが扱うのは、チームがすでに特定し、優先順位を付けた作業です。欠陥数や静的解析の結果を中心に優先順位を決めると、理解や意図の欠落は、問題を起こすまで十分に注目されないかもしれません。その間にも、十分に検討されていない判断の上に新しい依存関係が積み重なります。
AI生成の変更をどう管理するか
チームが書くコードが増えるほど、素早く検証し、テストでは見逃しうる問題を見つける方法が必要になります。これには、独立したレビュー、不明な領域の追跡、レビュー時に誰もが要件を確認できる状態の整備が含まれます。こうした取り組みは、未解決の疑問がシステムのほかの部分に影響する前に、それを解消する助けになります。
1. 提案された変更を独立して検証する
生成されたコードを、要件とリポジトリの現在の状態に照らして確認します。機能と一緒に書かれたテストは有用ですが、コードと同じ誤りを繰り返している可能性もあります。独立したレビュアーが、その前提を問い直すのに必要な情報を得られるようにしましょう。そのフィードバックを使って、変更が受け入れ可能かを判断します。
自動チェックで、チームが定義できる動作を確認すれば、レビュアーはシステムに関する深い知識が必要な判断に集中できます。重要な変更を行うエンジニアは、採用した方法を説明し、裏付けとなる証拠を示せるべきです。十分にレビューできないほど作業が多い場合は、キューに優先順位を付け、同時に進める作業量を制限します。
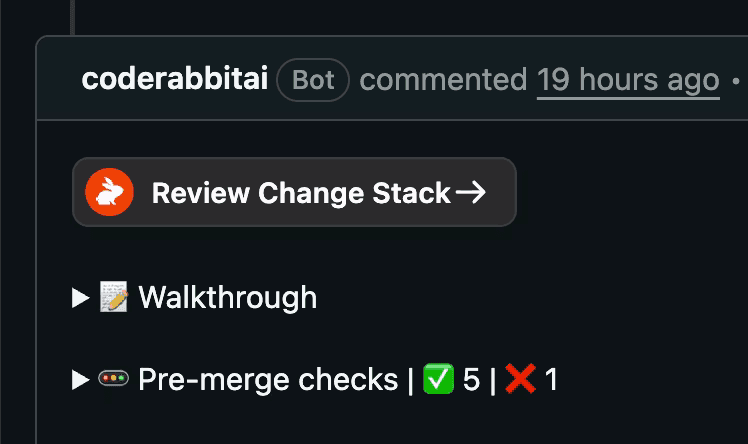
CodeRabbit Change Stackは、プルリクエストを順序付けられたレイヤーに整理し、差分に対応する説明を示します。レビュアーは各部分のつながりを確認し、実装が意図した動作に合っているかを検証できます。
2. 理解と意図の欠落を分けて追跡する
認知的負債がある場合、エンジニアが不慣れな部分を調査し、その仕組みをチームに説明する必要があるかもしれません。意図の負債がある場合は、要件の責任者に確認し、その理由を書き残すことが役立ちます。
未解決の疑問ごとに、誰が答えるべきか、どの計画中の変更がその回答に依存するかを決めます。自動PRチェックは、未解決の疑問があるコードに触れる変更や、要件へのリンクが欠けている変更にフラグを立て、適切な責任者が承認前に調査できるようにします。また、最近のPRを見直し、マージ前に回答されなかった設計上の疑問を探すこともできます。同じ疑問が繰り返されるなら、以前の回答が共有または文書化されていなかった可能性があります。これは、問題が起きる前に調査の時間を確保すべきという兆候です。
3. 変更をまたいで判断を保持する
重要な制約をエンジニアとエージェントが見つけやすくし、可能であれば動作を確認するテストも含めます。レビューガイドラインを通じて、そうした判断を将来のプルリクエストにも引き継ぎ、コントリビューターがチームの既存の要件に照らして変更を確認できるようにします。
要件が変わるたびに、その説明と関連するチェックを更新する担当者を決めます。誰も更新しなければ、レビューで古くなった判断が引き続き適用されるかもしれません。
生成される変更が増えるにつれ、その文脈はレビューコメント以外にも生かすべきです。どのプルリクエストを優先するか、システムへの影響をどう理解するか、デプロイ後に生じたリスクをどう調べるかという判断にも役立ちます。こうしたすべての活動で知識を利用できるようにすることが、AI生成コードの技術的負債を管理する鍵です。
これらの取り組みには、チームが記録する要件、レビュアーが評価する変更、エンジニアが後に保守するコードの間の連続性が必要です。CodeRabbitのAgentic Change Managementプラットフォームは、独立したレビュー、優先順位付け、説明可能性、継続的なコードベース監視によって、この作業を支援します。独立したAI Code Reviewは、リポジトリの文脈とチームの基準を使って提案された変更を確認します。Triageは、リスクと準備状況に基づいて、レビュアーが注目すべき変更を絞り込むのに役立ちます。Change Stackは、変更の各部分のつながりを示し、エンジニアが詳しく確認すべき箇所を把握できるようにします。変更のマージ後は、CodeRabbit Securityがコードベースのセキュリティおよびビジネスロジック上のリスクを調べ、修正をレビュープロセスに戻します。
アーキテクチャ上の判断と、その背後にある要件の責任は、引き続きチームにあります。プラットフォームは、変更の各段階で判断するエンジニアに適切な文脈を提供することで支援します。
まとめ
実装の速度がチームの理解を上回ると、AI生成コードの技術的負債はより速く膨らむ可能性があります。十分に検討されていない判断に新しい機能が依存するようになると、コードを修正する際には、その背後の理由や要件も取り戻す必要があります。
独立した検証、認知的負債と意図の負債の個別の追跡、判断の文書化によって、チームは修正コストが高くなる前に不足を補えます。CodeRabbitのAgentic Change Managementプラットフォームを活用し、AI生成の変更を管理するプロセスに、検証、優先順位付け、説明可能性、継続的な監視を取り入れてください。