コーディングエージェントに求められる仕事は、独立した小さなタスクから拡大しています。今ではリポジトリの理解や複数ファイルにまたがる判断、プロジェクトの大きな範囲における目的から実装まで進めることが期待されています。私たちは、この基準を基にFable 5.1をテストしました。
Fable 5は、実行前にプロジェクトについて時間をかけて調べるモデルでした。大きなコーディングタスクでは役立ちましたが、レビューは遅く、コメント数も必要以上に多くなりました。Fable 5.1は環境を確認してから計画する習慣は残りつつ、最終レビューに残す指摘を抑えています。
私たちのおすすめは、用途を絞ってFable 5.1を使うことです。問題を広く見つけることが速度より重要な、複雑性の高い変更に向いています。通常のプルリクエストには、より速く精度の高い標準設定が適しています。コーディングでは、明確な完成条件や十分なプロジェクト情報、そして計画する時間をFable 5.1に与えましょう。
Fable 5から変わったこと
Fable 5.1は小さなコーディングタスクでは速く感じられ、大きな作業ではより慎重に進行しました。コードレビューでは、Fable 5とほぼ同じ数の既知の問題を見つけながら、最終コメントを87件、Nitpick系コメントを186件減らしました。そして、適合率は4.5ポイント上がりました。
その代わり、時間は長くなりました。Fable 5.1は1件のレビュータスクに平均18分38秒かかり、Fable 5は12分32秒でした。2つの評価ではレビューシステムのバージョンが異なるため、この比較は同じ日の直接対比ではなく、変化の方向を示すものだと見てください。コーディング速度についても、テストした作業が異なるため定性的な比較にとどめています。
テストした内容
レビュー評価は、45件のレビュータスクと105件の既知の問題ポイントを対象にしました。再現率は既知の問題をどれだけ見つけたか、適合率は最終コメントのうち有効と判定された割合を示します。総コメント数は、CodeRabbitがモデル出力を処理した後に残ったコメント数です。テストした2つの設定は、推論量の違いに応じてLowとHighと表記します。コーディングに関する記述は別のテストに基づき、レビュー指標には含まれません。
私たちの見解
Fable 5.1は、すべてのプルリクエストを置き換える標準レビュアーではなく、用途を絞ったレビュアーと言えます。今回の結果では、Lowが優位でした。Highは時間が長く、全体で見つけた既知の問題も少なかったため、追加の時間が自分たちのコードベースで役立つと確認できた場合に使うのが良いでしょう。コーディングでは、目指す成果とモデルが判断してよい範囲をプロンプトに明記したときに最も良い結果を出しました。
Fable 5.1のコードレビュー
Fable 5とFable 5.1は、どちらも既知の問題を含む同じ105件の評価ポイントを使っているため、最も比較しやすい組み合わせでした。ただし、新しいテストでは更新されたレビューのパイプラインを使っているため、時点の異なる比較として読む必要があります。
| レビュー結果 | Fable 5 | Fable 5.1 | Fable 5からの変化 |
| 再現率 | 61.9%(105件中65件) | 61.0%(105件中64件) | -1.0ポイント |
| 適合率 | 32.8% | 37.3% | +4.5ポイント |
| 総コメント数 | 253 | 166 | -87件(-34.4%) |
| Nitpick系コメント | 265 | 79 | -186件(-70.2%) |
| タスクあたりのレイテンシー | 12:32 | 18:38 | +6:06(+48.7%) |
再現率は、105件の評価ポイントのうち、レビューシステムが少なくとも1件の有効なコメントを出した割合です。これは、本評価固有の数字で、モデル全体の一般的な再現率ではありません。適合率は、レビューのパイプラインが出力を処理した後、判定で有効とされた最終コメントの割合です。総コメント数は処理後に残ったコメントで、Nitpick系コメントは別に示しています。レイテンシーはタスク1件の平均で、評価全体の合計時間ではありません。
Fable 5.1が見つけた既知の問題は、Fable 5より1件少なくなりました。改善点は出力量を減らしたことです。開発者が確認する最終コメントは87件減り、適合率は上がりました。ただし、適合率37.3%では最終コメントの多くが有効と判定されておらず、まだ結果的にノイズがあります。モデル出力がプルリクエストに送られる前に、リポジトリの情報と独立した検証を加える仕組みが必要だと言えます。
推論を増やしても全体の結果は良くならなかった
推論量による違いを比べるため、2つのレビュー設定を掲載します。Lowは推論量が少ない設定、Highは推論量が多い設定です。どちらも同じ45件のレビュータスクを完了しました。
| レビュー設定 | 再現率 | 適合率 | 総コメント数 | Nitpickコメント | タスクあたり時間 |
| Low | 61.0% | 37.3% | 166 | 79 | 18:38 |
| High | 57.1% | 36.4% | 165 | 88 | 21:36 |
Lowは再現率61.0%で、タスクあたりの平均は18分38秒でした。Highでは再現率が57.1%に下がり、21分36秒かかりました。一部の難しいケースでは推論を増やすと改善しましたが、件数が少なく、広い結論には使えません。評価全体ではHighの方が遅く、見つけた既知の問題も少なくなりました。これは、Opus 4.8の評価でも同じ傾向が見られました。
レビューあたりの時間と呼び出し回数
各レビュータスクでは、約2.0回のファイルレビュー呼び出しを使いました。これはファイルをレビューするためのモデル呼び出しで、再試行や分割されたファイルの処理を含みます。どちらの推論グループも、同じタスク数を同じ呼び出し回数で完了したため、重要な違いは呼び出し量ではなく時間に現れました。
| レビュー設定 | 完了タスク | ファイルレビュー呼び出し | タスクあたり呼び出し | タスクあたり時間 |
| Low | 45 | 92 | 2.0 | 18:38 |
| High | 45 | 92 | 2.0 | 21:36 |
Highはファイルレビュー呼び出しを増やさず、タスクあたり約3分長くかかりました。品質指標と同じく、推論を増やすと時間は延びても、レビュー全体は改善しませんでした。Opus 5レビューとは異なり、この評価では信頼できる入力・出力のトークン数を記録していないため、トークン消費量は掲載していません。
Fable 5.1のコーディング
Fable 5.1は編集前に、インストール済みのツールや利用できるリソースを確認し、計画を書くことが多々ありました。簡単なコーディングタスクでは、動くデモを数秒で作り、以前のFableより速く感じられました。そしてタスクが複雑になり、必要な推論が増えるほど、以前のバージョンより時間がかかるように感じました。それでも計画と実装を分けると、変更前にプロジェクトを理解する時間を取れるため、結果が改善しています。
Fable 5.1が不足した情報をどう扱うかを見るため、あえて具体性を下げた指示も与えました。モデルは書かれた作業を終えて止まり、プロンプトの空白(指示していない内容)をすべて別の問題として解こうとはしませんでした。この抑制は、実務で役立つでしょう。以前のAnthropicモデルは、曖昧さに不安を感じているかのように、空白を埋めようとして作業範囲を広げることがありました。Fable 5.1はプロンプトを深読みしすぎず、依頼した範囲にとどまる傾向がありました。関連する変更も求めるなら、その要件を明記し、確認なしで進めてよい範囲を伝える必要があります。
複雑なテスト:SnakeからAIアリーナへ
難しいコーディングテストのひとつは、既存の一人用Snakeアプリから始まりました。Fable 5.1に、自律的に動作する5体のスネークが20 × 20のボードで競う観戦用アリーナへ置き換えるよう依頼しました。各スネークは独自の戦略で動き、ゲームはBattlesnake(バトルスネーク)のルールに従う必要があります。同じ決定論的なエンジンをブラウザとコマンドラインシミュレーターで動かし、戦略のバランスを自動テストで検証することも求めました。
動画では、5つのAI戦略が競い、画面がそれぞれの現在の判断を説明しています。画面に見えるアリーナは作業の一部にすぎません。内部では既存のゲームエンジンを置き換え、5体が同じルールのもとで同時に動く結果を処理する必要がありました。ブラウザとコマンドラインシミュレーターで同じシードから同じ結果を出し、数百回の対戦を通じて自動テストでバランスを測ることも必要でした。
ほかのモデルで試した際は、5つの戦略すべてを均衡させることに苦戦しました。1体がすぐに優位になったり、ほかが早く脱落してしまい、対戦は50〜100ターン程度で終わることが多くありました。この動画の対戦は793ターンまで進んでも2体が残っており、Fable 5.1が1つの戦略を明らかな本命にせず、バランスを丁寧に考えたことが分かります。さらに、各スネークが何をしようとしているかも画面に示しています。この種のタスクで、ほかのモデルが加えることのなかった要素です。
この結果は、Fable 5.1に明確な目標を与え、リポジトリを確認する時間を確保したことで生まれました。複雑な作業では、時間をかける進め方が結果につながることも示しています。目に見える体験がプロジェクト全体の方向に合うまで、内部の仕組みを改善し続けました。プロンプトリクエストを使えば、実装前にチームでこうした前提情報を確認できます。
Fable 5.1を類似モデルと比べる
この表を、単なるランキングとして読まないでください。各レビューは別の時期に行われ、レビューシステムのバージョンも異なります。Fableの2行は、どちらも既知の問題を含む105件の評価ポイントを対象としています。Opus 5とGPT-5.6 Solは、その後に別の設定で行ったテストの結果です。
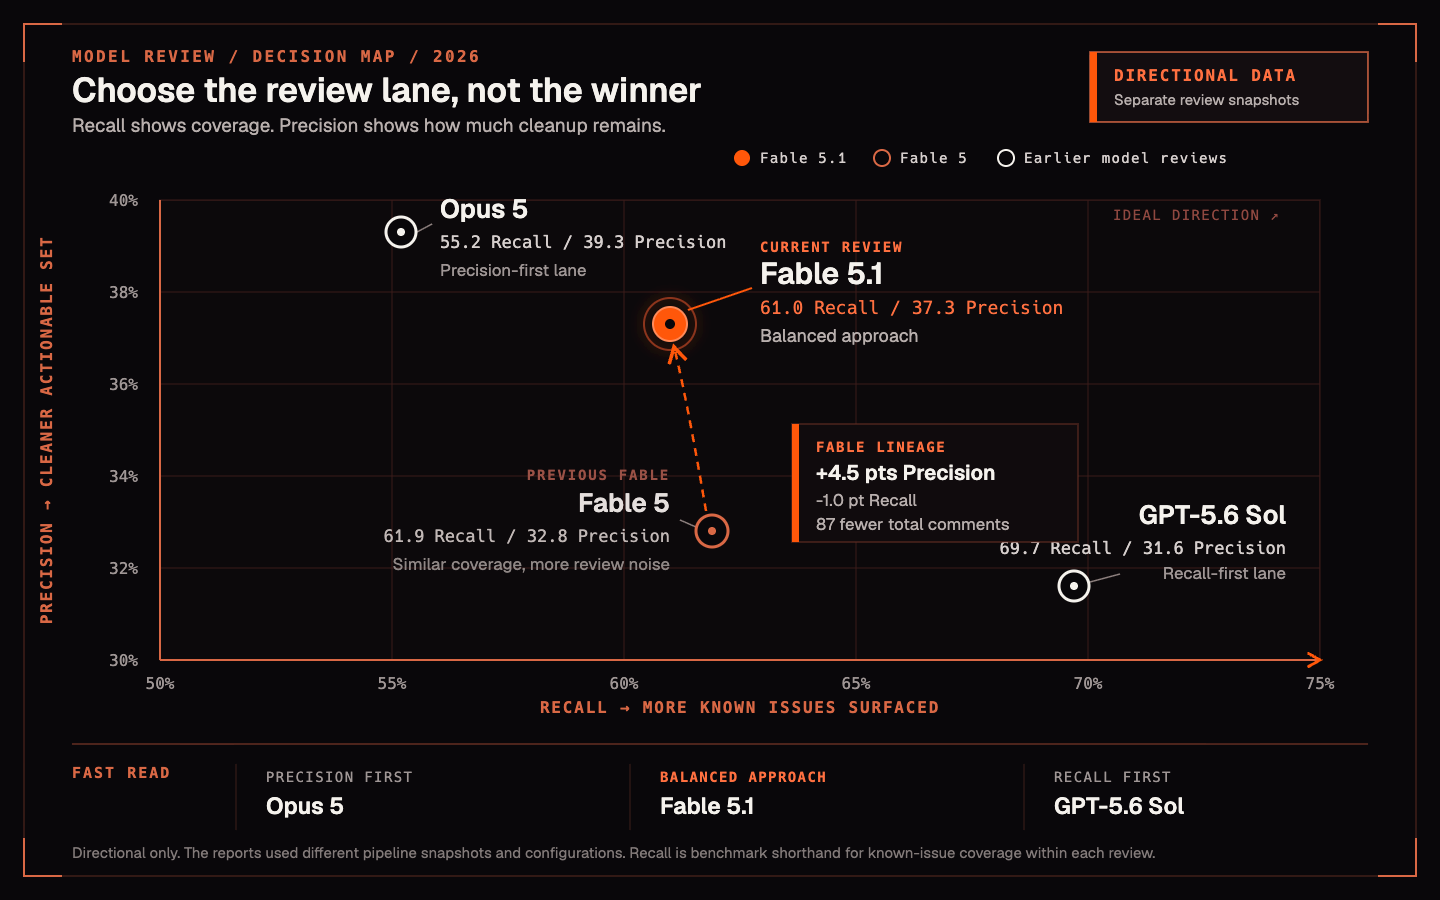
これらのトレードオフを最も早く読む方法は、意思決定マップとして見ることです。右へ進むほど再現率(Recall)が高くなり、上へ進むほど適合率(Precision)が高くなります。Fableの矢印は、Fable 5からFable 5.1への系譜上の変化を示しています。ほかのモデルは公開レビューごとにパイプラインのスナップショットが異なるため、あくまでも方向性を示す比較として扱ってください。
| モデルレビュー | 再現率 | 適合率 | コメント数 |
| Fable 5.1 | 61.0% | 37.3% | 166 |
| Fable 5 | 61.9% | 32.8% | 253 |
| Opus 5 | 55.2% | 39.3% | 166 |
| GPT-5.6 Sol | 69.7% | 31.6% | 231 |
Fable 5.1とFable 5は、どちらも105件の評価ポイントを使っているため、最も参考になる組み合わせです。Opus 5はFable 5.1より高適合率・低再現率で、公開された設定ではどちらも166件のコメントを出しました。GPT-5.6 Solは高再現率・低適合率で、コメント数は231件でした。Solのレビューはプロダクトによるフィルタリング前のモデル出力を数え、FableとOpusのレビューは処理後のコメントを数えています。テストした評価時点が異なるため、これらの数字は固定された順位ではなく、確認すべき違いを示しています。
自分の環境でFable 5.1を評価する方法
自分たちのリポジトリを代表するようなプルリクエストでテストしてください。既知の問題をいくつ見つけたか、最終コメントのうち何件が有効だったか、レビューにかかった時間、開発者が確認する出力量を記録します。不完全なコーディング指示もいくつか含め、モデルがどの要件を推測し、どれに手を付けないかを確認します。その後、難しいケースを計画先行の指示とHigh設定でも繰り返し、追加の時間が自分たちの作業で結果を変えるかを調べましょう。
最終評価
Fable 5.1は、Fable 5より扱いやすくなりました。既知の問題を見つける範囲はほぼ同じで、コメント数は減り、適合率が向上しています。コーディング指示に不足した情報がある場合、依頼された範囲を尊重する傾向が強くなりました。標準設定を変える前に自分たちのリポジトリで試すべき主な理由としては、レビュー時間が長くなったことが挙げられます。CodeRabbitの説明可能なレビューシステムは、プロジェクトの意図とコードの根拠を使ってモデル出力を信頼しやすくする方法を示しています。