CodeRabbitは数か月前にCodeRabbit Securityを公開しました。AIによる推論を使い、コードに潜む深く複雑な脆弱性を見つける製品です。私たちはCodeRabbit Securityとほかの3つのシステムを対象に、オープンソースリポジトリの既知の脆弱性を検出する能力をテストしました。
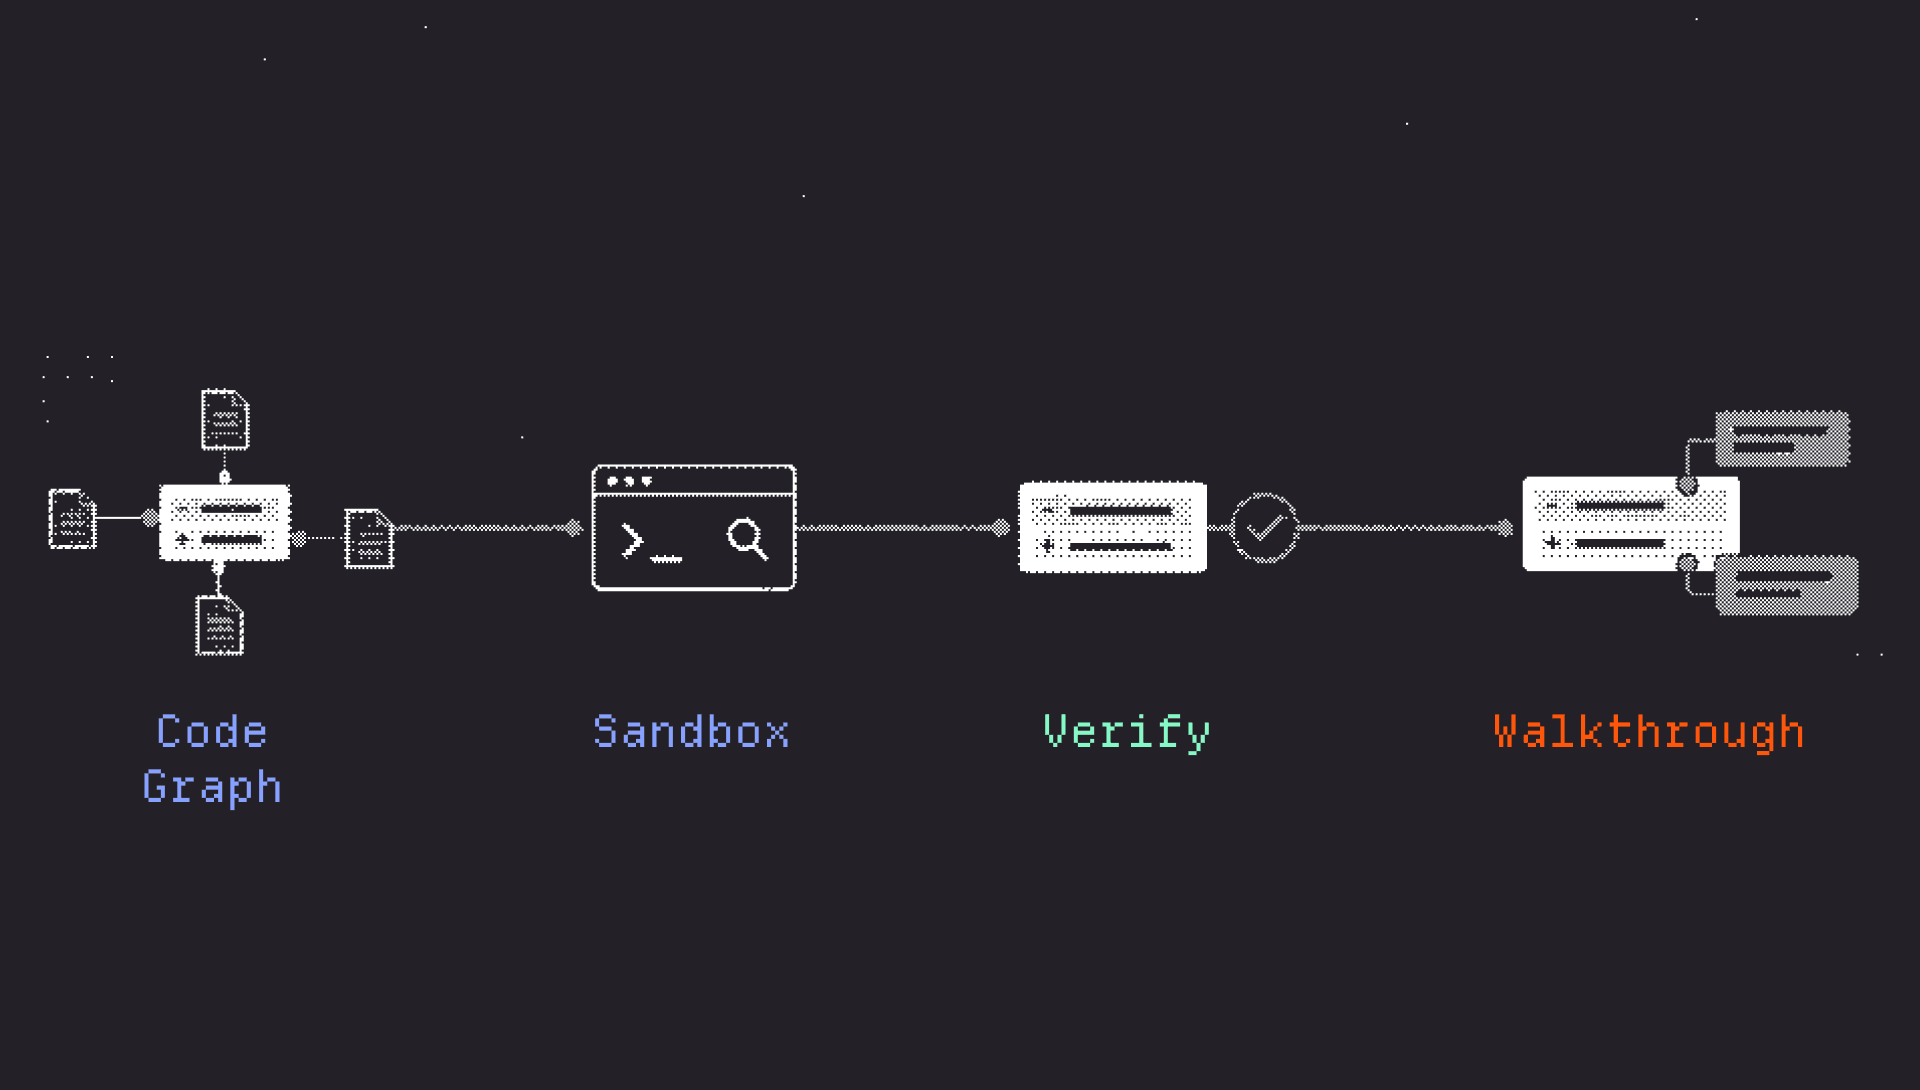
CodeRabbit Securityの中核は、Map、Hunt、Verify、任意のFixという段階的な処理です。コードベースをマッピングし、攻撃経路の候補を調査し、ソースに照らして検出候補を独立に検証した上で、裏付けのある指摘に対する修正案を作成します。このベンチマークでは、そのプロセスによって既知の脆弱性を検出できるかを測定します。検出として認められるには、指摘が対象の脆弱性を特定し、経路上のアプリケーションの防御策も考慮しながら悪用方法を説明する必要があります。
結果
以下は、社内の開発用比較サブセットに基づく結果です。
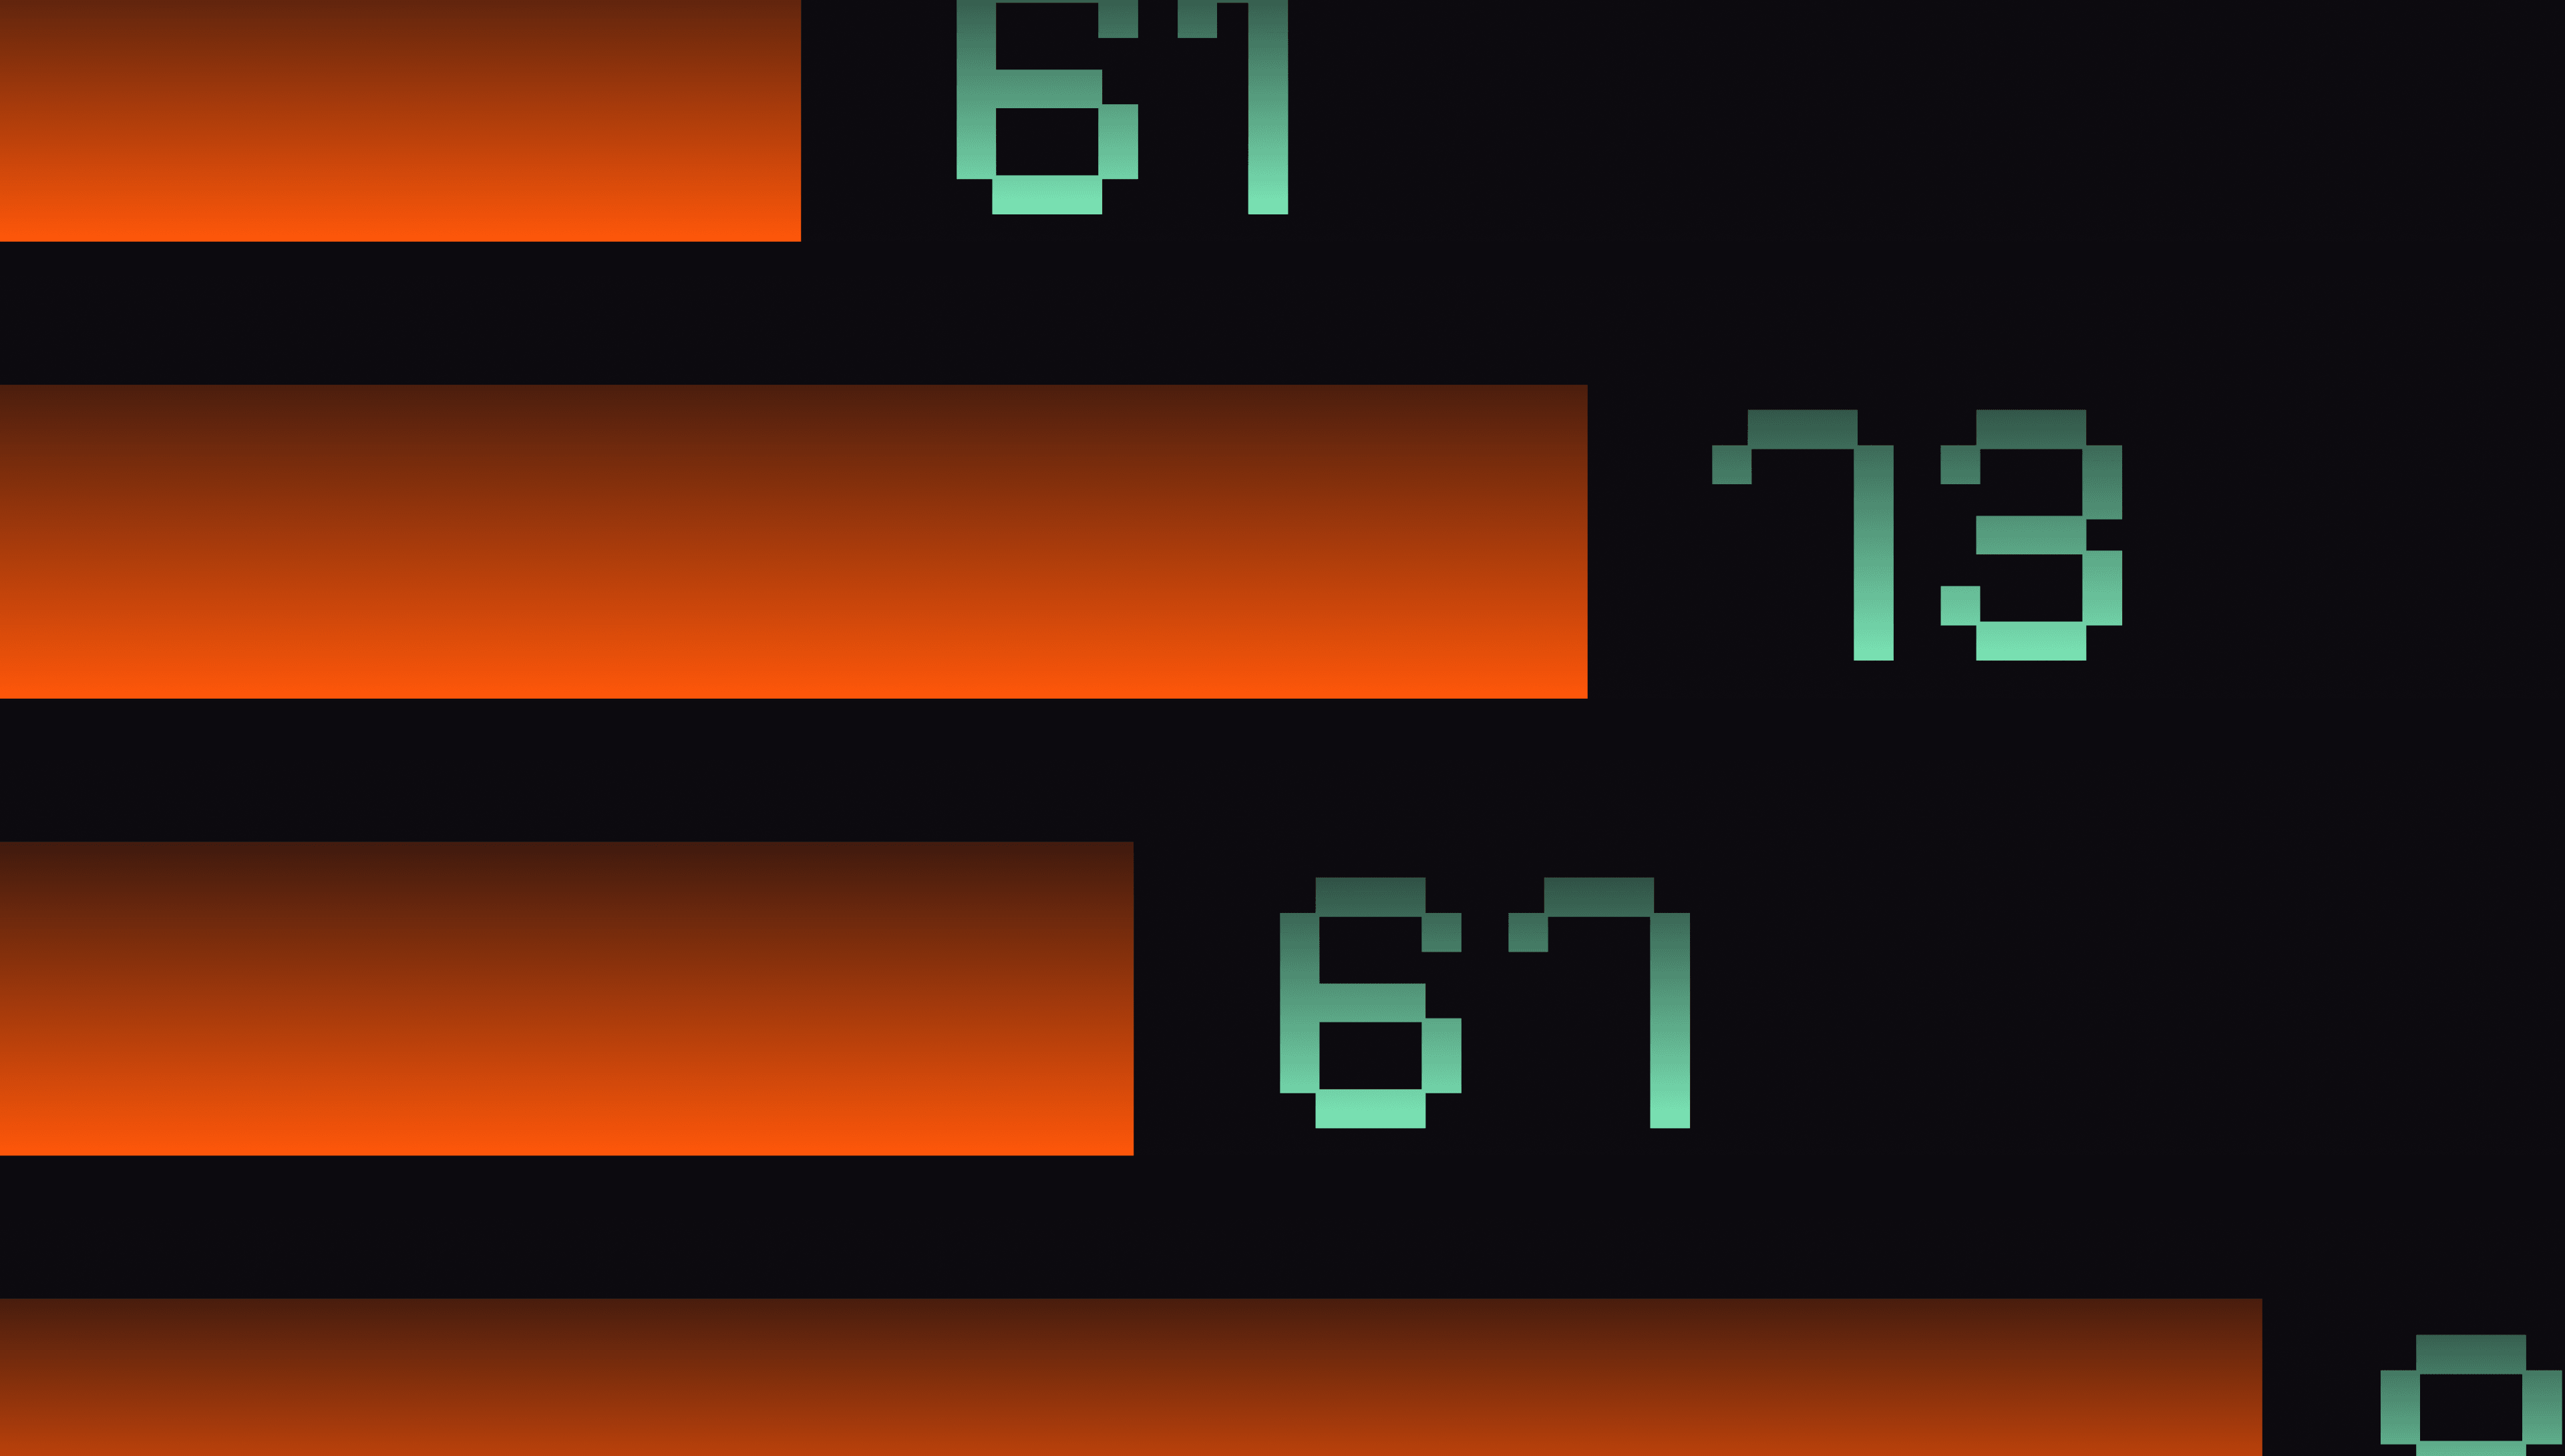
脆弱性検出率:CodeRabbit 86.7%、Devin 73.3%、Codex Security Plugin 62.0%、Claude Security 40.0%。社内の開発用比較サブセット。
このベンチマークでは、最終的な割合だけでなく、より具体的なことも調べられます。脆弱性を見逃した場合、分析がどこで途切れたのかを追跡できます。入口を見落としたのか、有用な仮説が段階の間で失われたのか、あるいは正しい指摘が検証時に却下されたのか。それぞれの失敗が、パイプラインで改善できる具体的な作業を示します。
実際の脆弱性から評価を組み立てる
評価事例はGitHub Advisory DatabaseとOSVデータベースから取得しています。
各システムには、アドバイザリとパッチを伏せた状態で脆弱なソースコードを渡しました。実際のリポジトリにある既知の脆弱性を選んだのは、それぞれの欠陥を理解するために必要な周辺コードや設定を残すためです。悪用できるかどうかは、フレームワークの挙動、ファイル間のデータの流れ、または手前の認可チェックが攻撃を防ぐかどうかに左右される場合があります。
評価対象の構成は次のとおりです。
評価対象:脆弱性100件、リポジトリ94件、11言語、脆弱性11系統。重大度:緊急12件、高50件、中38件。
事例は、認証、認可、インジェクション、デシリアライゼーション、SSRF、XSS、暗号、データ漏えい、パス処理、プロトコルの完全性、サービス拒否にまたがります。各事例について、脆弱性を修正したコミットとその直前の親コミットを特定します。その上で、親コミットに脆弱なコードが含まれ、事例が評価要件を満たすことを確認します。
セキュリティエージェントに渡すもの
エージェントには、脆弱なリポジトリのスナップショットを渡します。Gitの履歴とリモートを削除し、ネットワークにアクセスできない状態でスキャンを実行します。ベンチマークの指示からは、アドバイザリ、GHSAまたはCVE識別子、CWE分類、重大度、リポジトリの識別情報、脆弱なファイル、対象行、修正コミット、パッチ適用後のソースも伏せます。これらの情報は評価者の正解データにのみ残します。
この制御により、スキャン中に利用できる手掛かりを制限します。ただし、脆弱性とリポジトリは公開されているため、モデルが学習時にそれらを見ていた可能性は別の懸念として残ります。この制約を踏まえ、私たちはこの設定を、条件を制御した脆弱性検出テストとして扱っています。
CodeRabbit Securityを詳しく見る
このベンチマークは脆弱性の検出を測定します。修正品質は報告したスコアの対象外です。
Map
AIエージェントが安全なサンドボックス内でリポジトリを探索し、アプリケーション全体のマップを作成します。入口、信頼境界、認証・認可チェックと、それらの関係を特定します。また、外部から到達できる入力と、その入力が影響を及ぼせるコードやリソースをつなぐ到達可能性グラフも作成します。これにより、アプリケーションの構造に即した攻撃経路に調査を集中できます。
Hunt
マップを使って調査範囲を絞ります。専門エージェントが、認可、インジェクション、ビジネスロジック、データ漏えい、AI固有の脅威など、異なるリスク領域を並行して調べます。攻撃者が制御する入力を入口からシンクまで追い、途中の信頼境界と制御を調べ、各脆弱性候補を裏付けるコードを収集します。
Verify
CodeRabbitが指摘を公開する前に、その指摘は独立した検証に耐える必要があります。
検証担当は引用された経路を改めて開き、コードに到達できるか、アプリケーションの別の場所に防御策がないか、悪用に必要な条件が成立するか、そして証拠が主張された影響を裏付けているかを確認します。
重複は除去します。テスト専用または到達不能なコードに依存する候補、既存の保護を見落とした候補、裏付けのない前提に基づく候補も却下します。証拠からどちらとも結論づけられない場合、CodeRabbitはその不確実性を示します。不完全な分析を、悪用できる証拠やリポジトリが安全である証拠として扱うことはありません。
(任意)Fix
対象となる指摘では、Fix with AIが確認済みの攻撃経路とアプリケーションの文脈を使い、セキュリティブランチに範囲を絞った修正案を作成し、レビュー可能なプルリクエストまたはマージリクエストを開きます。PRには、入口とシンク、到達可能性の分析、悪用条件、想定される影響まで、指摘の技術的な説明を残します。
開発者はパッチと推論を確認し、既存のテストやチェックを実行してからマージを判断します。指摘、証拠、提案された修正、レビュー履歴は、スキャナーのダッシュボード、チケット管理、別の修正プロジェクトに分散せず、開発ワークフロー内にまとまります。
スキャナーが追跡すべきコード経路
以下のインタラクティブな図では、4つの事例を紹介します。各事例をクリックすると、脆弱性、評価する内容、裏付けとなる証拠を確認できます。
評価事例:deepstream、python-statemachine、Fission、pymonocypher。CVSSスコアは順に9.9(v3.1)、9.3(v4.0)、9.9(v3.1)、5.1(v4.0)。根拠は本文の各事例を参照。
これらの例では、機密性の高い操作を見つけることは出発点にすぎません。スキャナーには、そのアプリケーションで脆弱な挙動がどう生じるかを説明し、指摘を裏付けるソースを特定することが求められます。
採点方法
報告された指摘が、正解ラベルの脆弱性の根本的な仕組みと、認められたソース位置で一致した場合に、検出として加点します。同じファイルにある別の脆弱性は、その対象の検出としては加点しません。CWE分類が一致するだけでも不十分で、異なる攻撃経路を説明している場合は対象になりません。重複報告は1件として数え、インフラの障害はモデルの見逃しとは別に記録します。
この採点方法で測るのは、システムが既知の対象をどれほど検出できたかです。追加の指摘には、別の評価が必要です。
モデルの組み合わせが有効な理由
実験では、複数モデルを組み合わせた構成と、単一モデルの構成を比較しました。それぞれの組み合わせが既知の脆弱性の検出数にどう影響するか、指摘が調査、検証、報告を通じてどの程度残るかを評価しました。
モデルの選択にはコストのトレードオフもあります。ある段階で安価なモデルを使うと実行コストを下げられる一方、最終報告に届く正しい指摘が減る可能性があります。そのため、ある段階の出力が後続処理に与える影響も含め、変更ごとにパイプライン全体を評価しました。
優れたハーネスがあってこそ、優れたモデルは能力を十分に発揮できます。強いモデルでもハーネスが弱ければ、結果は平均的なものにとどまります。一方、弱いモデルを最高のハーネスだけで救うことはできません。両者の効果は重なるため、CodeRabbitはモデル選択と同じくらいハーネスにも投資しています。
私たちは、パイプライン全体でモデルの選択と振り分けを調整し続けています。新しいモデルが登場するたびに、どの段階に適しているか、どの組み合わせが検出能力を高めるかをテストします。
CodeRabbit Securityの今後のアップデートにもご期待ください。
以下のCodeRabbit Securityのローンチ動画で、実際の動作をご覧ください。