エージェント型コードレビューとは
エージェント型コードレビューは、AIエージェントが変更案を調査する手法です。関連するリポジトリのコンテキストを集め、依存関係をたどり、利用可能な解析ツールを使って、指摘の根拠を作成者に説明します。調査で分かったことに応じて、次に確認する内容を変えられます。マージに必要なチェックと人間の承認は、引き続きチームが決めます。
エージェント型コーディングを導入するチームでは、生成された変更を別のレビュー工程で検証できます。本ガイドでは、その仕組み、役立つ場面、既存のマージ条件を弱めずに導入する方法を説明します。
エージェント型コードレビューの具体例
この説明用のPRは、請求書をダウンロードするエンドポイントを追加します。ハンドラーはIDで請求書を取得し、PDFを返します。テストにはログイン中のアカウントが所有する請求書を使っているため、正常なリクエストは成功します。一方、要件には「別のアカウントの請求書をダウンロードできないこと」も含まれています。
- コンテキストを集める。 リンクされた要件、ルートのミドルウェア、請求書のクエリ、既存の認可テストを確認します。請求書が認証済みアカウントに属することを、どこで確認しているかが調査の焦点です。
- 処理経路を調べる。 ミドルウェアは呼び出し元を認証していますが、新しいクエリは請求書IDだけで検索しています。後段の認可チェックがレスポンスを止めるかを確認します。認証だけでは、その請求書へのアクセス権は確認できません。
- 根拠とともに指摘する。 有用なコメントは、対象クエリと所有者チェックの欠落を示し、別アカウントの情報が漏れる可能性を説明します。別アカウントの請求書を使った回帰テストも求めます。確認した処理経路と、参照できないサービスについての仮定を区別します。
- 修正を検証する。 作成者は認証済みアカウントでクエリを絞り込み、別アカウントへのアクセスを拒否するテストを追加します。CIがテストを実行し、レビュアーは更新された差分を確認します。レビューエージェントがテストを実行できない場合は、その制約とCIの結果を明記します。
- 承認の境界を維持する。 人間が意図した認可動作を確認します。必須チェックと人間の承認がマージを制御します。
この学習用の例は、調査の手順を示しています。問題を検出できるかは、レビュアーが利用できるリポジトリのコンテキストと解析手段によって変わります。CodeRabbitによるリポジトリのコンテキストの活用については、大規模コードベースのレビューを参照してください。
エージェント型レビュー、静的解析、自動マージの違い
Linterは設定されたルールを確認します。SASTには、関数やファイルをまたいでデータを追跡できるものもあります。CodeQLのデータフロー解析ドキュメントに、その仕組みが説明されています。こうしたチェックを維持しながら、要件や周辺のリポジトリコンテキストに照らして変更を調査するエージェント型レビューを組み合わせます。
渡された差分にコメントするLLMが使えるのは、与えられた情報とツールだけです。エージェント型のワークフローでは、コメントする前に追加の根拠を集められます。ワークフローが集める根拠と、実際に行う調査を評価してください。
自動マージは、リポジトリの承認ポリシーに従って個別に設定してください。まず開発者が確認できる指摘から始め、マージをブロックする条件は明示的に決めます。
AI支援チームにとってコードレビューが新しいボトルネックになる理由
検証が制約になると、チームはトレードオフに直面します。厳密にレビューすると、人間の確認がボトルネックになります。一方で、レビューを緩めると品質がリスクになります。
レビューの逼迫を示す数字
レビューの負荷は、いまやPRの量、AIコードの手直し、問題密度として測定できるようになっています。プラットフォーム全体のマージ済みPRは、2024年の月平均3,500万件から2025年には4,320万件へ増えました。AI生成コードは、人間が書いたコードよりレビューしにくいと感じられることもあります。
Stack Overflowの2025年開発者調査では、66%の開発者が「ほぼ正しい」AI生成コードの修正により多くの時間を費やしていると回答しています。また、AIの正確性への信頼は、過去数年の約40%から2025年には29%へ低下しました。この負荷はコードの中にも表れています。State of AIの調査では、AIが共同作成したPRは1PRあたり平均10.83件の問題があり、人間だけによるPRの6.45件を上回りました。
コーディングエージェントを増やす前にレビューを改善する
レビューを改善しないままコーディングエージェントを追加すると、キューはさらに膨らみます。AIによるコード作成はボトルネックをレビューへ移したため、チームには、すべてのシニアエンジニアを最終確認者にせずに、その出力を受け止められるレビューシステムが必要です。
Change Stackの例:関連する編集をレビューレイヤーにまとめ、差分の横に表示することで、変更を読み進める順序を示します。この画面はTanStack CLIのプルリクエストを表示しています。
Taskrabbitは、この順序を明確にしました。同チームはAIコーディングエージェントを採用する前にレビューを改善し、CodeRabbitで週300件のPRを扱いながら、マージまでの時間を10日から7日へ、25%短縮しました。
エージェント型コードレビューがLinterやSASTツールに加える価値
LinterやSASTツールはすでにパイプラインで動いているため、最初の問いは、エージェントがその上に何を追加できるのかです。
静的解析はルールの確認やデータフローの追跡を行えます。製品の要件に照らして変更をレビューするには、関連する意図とリポジトリのコンテキストも必要です。これは、問題がワークフローのロジックにある場合に重要になります。認可チェックの欠落、エッジケースの分岐、数ファイル離れた呼び出し元と呼び出し先の相互作用が、その変更が安全かどうかを左右することがあるからです。AI支援レビューでは、多くの重要な判断が、構文よりもコードの意味に依存します。
エージェントはどこからコンテキストを得るのか
多くの場合、より優れたAIレビューには差分だけではなく、周辺のコンテキストが役立ちます。CodeRabbitはPR、IDE、CLI、Slackを横断してレビューするため、一次フィードバックはワークフローがすでに存在する場所に届きます。コードグラフ、リンクされたチケット、過去のPR、チームの意思決定によって、エージェントはデプロイ前にランタイムエラー、nullポインタ例外、競合状態、ロジックの欠陥を把握できます。これにより、変更行だけを確認するレビューを超えられます。
エージェント型レビューの限界
エージェント型レビューにも限界があり、それを率直に示すことが信頼につながります。分析は、レビューセッションでエージェントが利用できるコンテキストに依存します。レビューセッションには、一部の依存関係や生成された成果物が含まれない場合があります。AIエージェントが提供するのは一次レビューです。マージ権限は人間のレビュアーが持ち続けます。
マージゲートを壊さずにAIエージェントをブランチ保護へ追加する方法
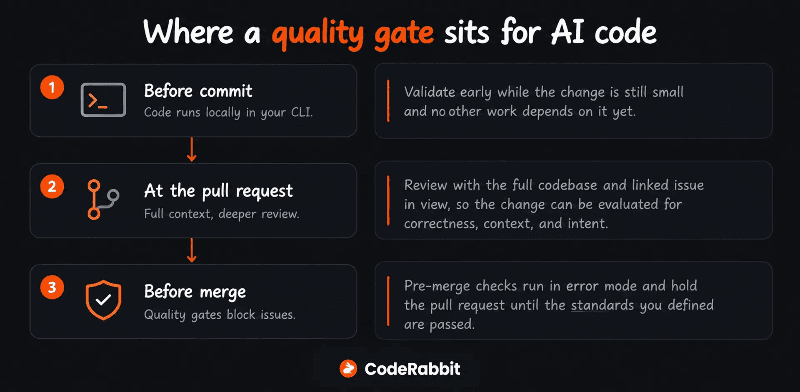
AIエージェントを既存のPRフローへ組み込む場所は2つあります。導入時にどちらを選ぶかが重要です。この2つのパターンは、GitHubとGitLabのブランチ保護の仕組みにきれいに対応します。
ブロックしないレビューコメント
GitHubのPRレビューモデルはCommentステータスをサポートしています。ドキュメントでは「承認や変更要求をせずにフィードバックを共有する」と説明されており、必須承認にはカウントされません。AIエージェントがCommentタイプのレビューだけを投稿する場合、マージ対象には触れずに、検出事項をPRへ追加できます。
内容を確認できるフィードバックの例:CodeRabbitのコメントがリファクタリングの提案理由と修正コードを示し、作成者がその妥当性を判断できます。
必須ステータスチェックによるブロック
GitHubのブランチ保護では、マージ前に指定されたステータスチェックを通過している必要があります。チームは、AIエージェントにコミットステータスまたはチェック結果を投稿させ、そのチェックをブランチ保護ルールで必須にすることで、ゲートへ組み込めます。
GitLabでは、同等の制御は保護ブランチにおけるコードオーナー承認と必須承認ルールを通じて行います。
任意から必須へ段階的に導入する
まずは、エージェントがコメントとステータスチェックを投稿するように導入します。ただし、最初は必須チェックには含めません。誤検出率が安定してから、そのチェックを必須に昇格させます。これにより、人間のコードオーナー承認を確認者として残しつつ、エージェントを可視化できます。必須チェックに依存する前に、スキップ、中立、失敗、タイムアウト時の動作を確認してください。GitHubでは成功、スキップ、中立の結果が必須チェックを満たし得ます。レビュー完了を指摘の解消と同一視しないようにします。
あるコードレビューボットに関する研究では、PR作成者が自動コメントの73.8%に対応したことが分かりました。また、その研究では自動レビュー後、人間のレビューが始まる前に88件のコミットが記録されました。自動フィードバックは、人がPRを開く前に作成者へ届いていたのです。エージェント型レビューも同じ流れを取れます。
新しいPRを自動でレビューし、コミットの追加に応じてフィードバックを更新します。CodeRabbitでは、変更要求ワークフローとカスタムのマージ前チェックのドキュメントを参照して、ブロック条件を決めます。その結果がリポジトリでどう強制されるかも確認してください。
AIエージェントにはできない、人間のレビュアーの役割
人が差分を開く前に、エージェントで定型的な検出事項を片付けます。そのうえで、レビュアーの注意をコンテキスト、オーナーシップ、リスクに向けます。この捉え方は、人間のレビューが何のためにあるのかを示してきた長年の研究とも一致します。
レビューの目的について研究が示していること
人間のレビューに価値があるのは、コンテキストと判断を移転できるときです。Bacchelli & BirdによるMicrosoftでの研究では、欠陥の発見はレビューの目的として掲げられ続けているものの、「レビューは予想ほど欠陥に関するものではない」とされています。むしろ、知識移転とチームの状況把握をもたらし、「コンテキストと変更の理解」があらゆるレビューの中心だと述べています。レビューのこうした部分は、差分を超えた共有コンテキストに依存します。ツールによって正しさのチェックを静的解析や自動テストへ移すことはできますが、確認作業そのものが不要になるわけではありません。Sadowski氏らによるGoogleのケーススタディは、「ツールによって、人間によるコード確認の価値が完全になくなることはないかもしれない」と述べています。
同じ原則は、Human in the loopのレビューフローにも見られます。Microsoft Engineeringは、これをAIによるコードレビューの設計原則として説明しています。エージェントは候補となる問題を表面化し、レビュアーが判断します。
責任は人間に残る
責任という点は、自動化では引き受けられません。リリースするのは引き続き開発者です。人間のレビュアーが来る前に、エージェントが差分を整理します。そうすることで、人間の注意を、人にしか答えられない設計上の問いへ向けられます。
エージェント型コードレビューが機能していることを示す指標
まずレビュー待ち時間から始める
導入前に3つの数字を選び、1か月間観察します。レビュー待ち時間は最初に動くため、そこから始めます。LinearBは、PR作成からコードレビューが始まるまでの時間を「レビュー開始までの待機時間」と定義しています。約2,000チームを対象にした同社のレビュー開始までの待機時間に関するベンチマークでは、エリート水準では7時間未満、推奨目標は1時間以内です。常時稼働する一次レビュアーは、この数字に直接効きます。最初の実質的なフィードバックが数分で届くようになるからです。
変更失敗率と欠陥流出率
次に、変更失敗率と欠陥流出率を追跡します。レビューが速くなっても、本番環境のバグが隠れて増えていては意味がありません。DORA(DevOps Research and Assessment)は、即時対応が必要になったデプロイの割合である変更失敗率を追跡しています。また、Jellyfishは欠陥流出率を品質診断の指標として挙げています。速いレビューに意味があるのは、本番環境へ到達するバグがそれに伴って増えない場合だけです。
レビュアーの時間がどう再配分されるか
3つ目の数字は、レビュアー時間の再配分です。これは、コメントタイプの分布を時系列で追跡するなど、自分たちで計測する必要があるかもしれません。
コメントに、細かな指摘、正しさ、セキュリティ、テスト、設計といったタグを付け、人間のレビューが後半の3つへ移っているかを観察します。レビューのタイミングを生産性の指標として扱う前例はあります。
開発者生産性を測定するモデルであるSPACEフレームワークは、コードレビューのタイミングを「効率と流れ」の観点に位置づけています。また、レビューが遅いことのコストは現実にあります。LinearBは、レビュー待ちで数日止まった小さなPRには、80%の割合で形式的な承認、つまり「問題ないと思います(LGTM)」というコメントが付いたことを明らかにしています。
freeeのエンジニアリングチームは、CodeRabbit導入を570シート、285リポジトリへ拡大する中で、6か月間に32.8週間分のレビュアー時間を削減しました。
導入前にエージェント型コードレビュアーを評価する方法
AIエージェントをゲートへ接続する前に、誤検出率を検証してください。そのうえで、関係の薄いコメントによって人々がエージェントを無視するようになる前に、チームが感度を調整できることを確認します。ここを誤ると、エージェントは聞いてもらえなくなります。
指摘の少なくとも90%が有用と感じられる状態を目指す
GoogleのTricorderの経験では、コードレビュー時の解析について、開発者が報告された指摘の少なくとも90%を実際の問題と感じることを推奨しています。この目標は、開発者が指摘を有用と感じる割合を示しています。AIレビュアーの指摘は、自分たちのリポジトリで評価してください。
信頼はすぐに損なわれることがあります。エンジニアが、エージェントのフィードバックは間違いや些細な指摘が多いと学んでしまうと、慎重に調査するのをやめてパターンだけで読み飛ばすようになる可能性があります。だからこそ、誤検出が悪い習慣を作る前の、導入前の期間が重要です。
重要度ごとに検出精度を評価する
実践的な検証手順のひとつは、スプリント中に代表的な検出事項をサンプリングし、シニアエンジニアに真陽性、偽陽性、判断が分かれるものへ分類してもらい、重要度ごとの精度を追跡することです。セキュリティの検出事項には、より広い許容幅があります。Googleのソフトウェアエンジニアリングに関するガイドラインでは、重大なセキュリティ問題を特定する解析であれば、レビュアーはより高い誤検出率を許容するとされています。
感度を調整して、有用な指摘を保つ
設定可能な感度は、誤検出への対策になります。パスベースの指示では、選んだパスにだけカスタムルールを適用できます。そのため、高リスクなディレクトリではレビュー量を増やし、それ以外では減らせます。AST-grepルールは、場所ではなくコードの形に依存するチェックに対して、構造的なパターンマッチングを追加します。CodeRabbit Learningsは、PRコメントから設計上の選択を保存し、以降のレビューに適用します。そのため、エージェントの指摘はぶれるのではなく改善していきます。
AIはかつてない速度でコードを書きます。そしてState of AIレポートも、同じ緩和策を示しています。先にコンテキストを与え、その後で独立して検証することです。
CodeRabbitのDavid Lokerは、こう端的に述べています。
「AIはアウトプットを加速しますが、同時に特定の種類のミスも増幅します」
コンテキストを十分に持つAIエージェントを、感度を調整した一次レビュアーとして組み込み、人間がゲートを保持する。これが、レビューを新しいボトルネックにせず、エージェント時代の速度でリリースする方法です。すべての行は、いまもマージに値するかを確認されます。
まず1つのリポジトリで指摘を確認し、レビュー待ち時間と採用された指摘を比較してから導入を広げましょう。CodeRabbitを使い始める。