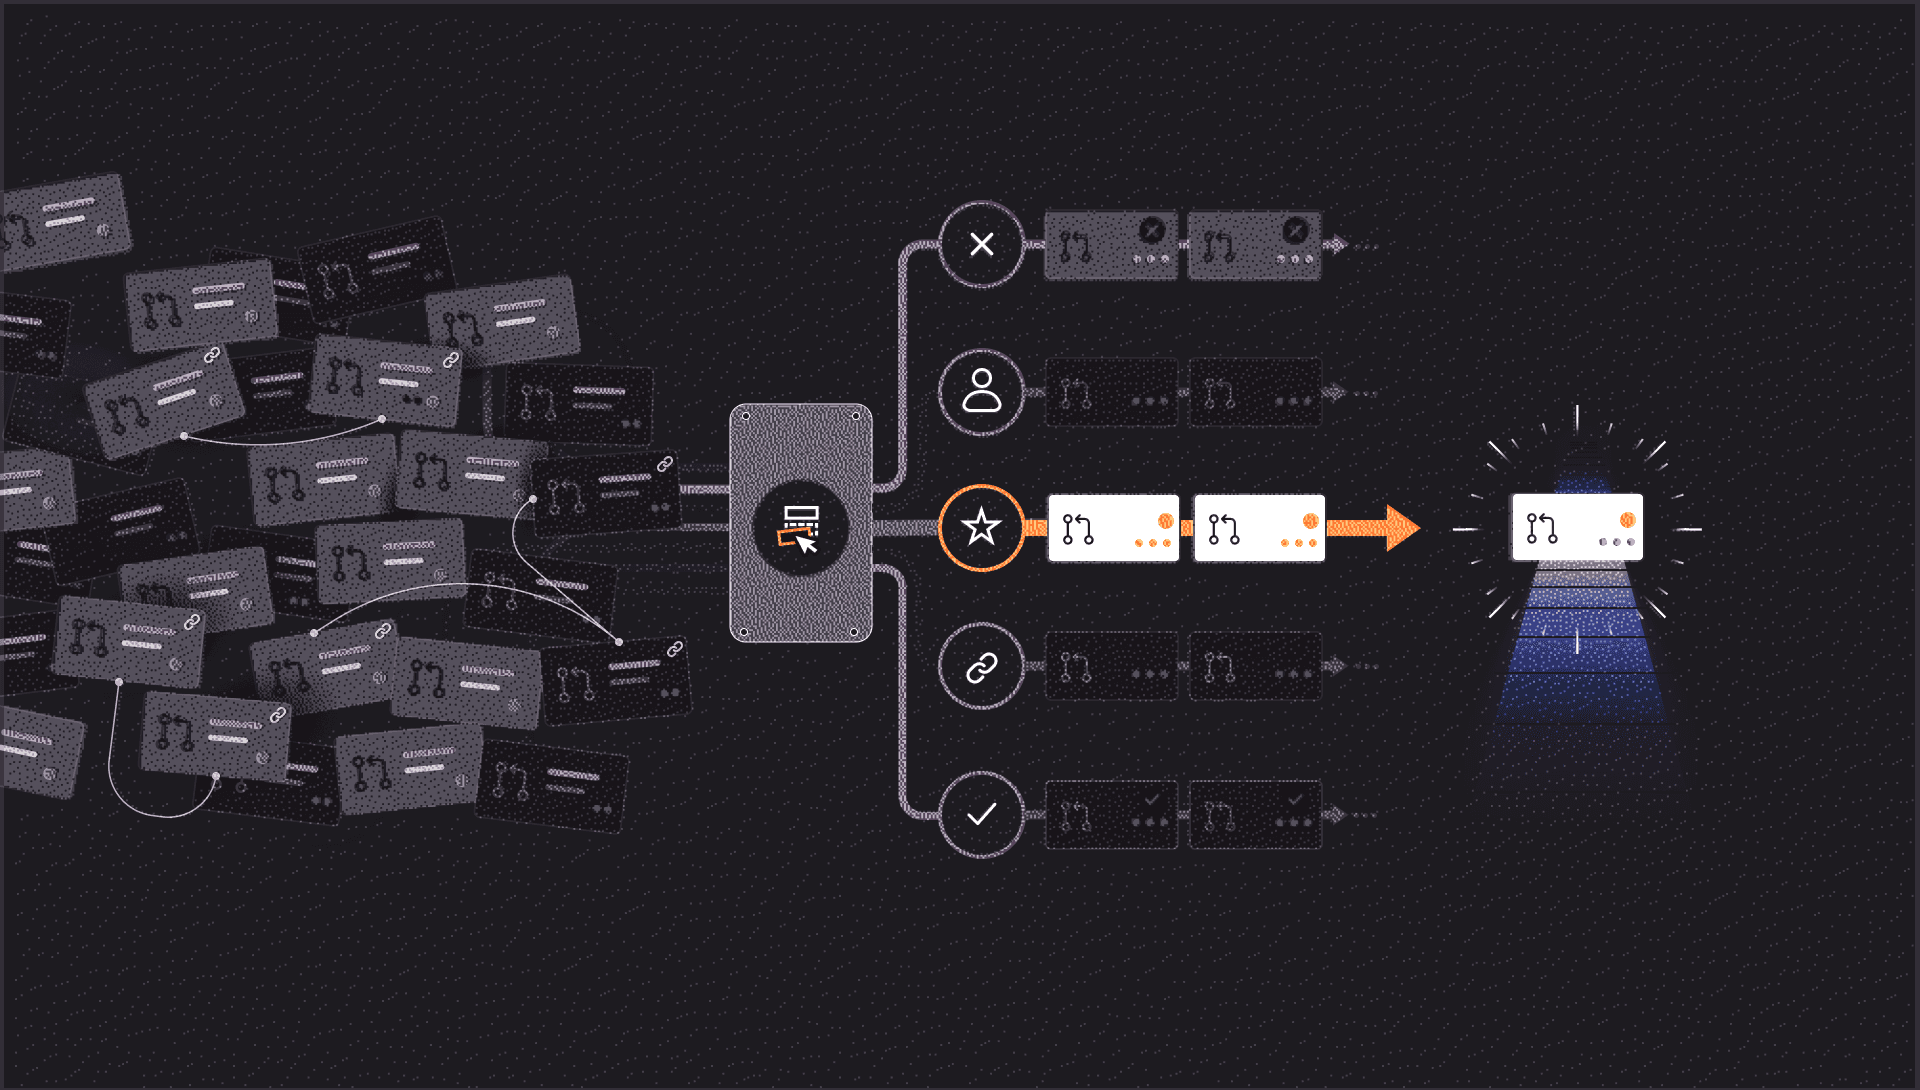
Opus 5.5が登場し、CodeRabbitのレビューパイプラインで何が変わったかを検証しました。以前のOpus 5の評価では、精度が高まる一方で、既知のバグの検出数が減りました。Opus 5.5は異なる結果を示しました。オープンソースのテストではバグ検出率が本番ベースラインをわずかに上回り、より難易度の高い小規模なセットでは、検出率と精度の両方がさらに大きく向上しました。その一方で、コメント数と報告されたトークン使用量も増加しました。チームが導入を判断するうえでの問いは、追加の検出がレビュー作業の増加に見合うか、そしてその代わりにどのバグを見逃すかです。
また、一晩かけて取り組むプロジェクトや、Grand Theft Auto: San Andreasに着想を得たゲームの実験を通じて、Opus 5.5のコーディング能力も実際に試しました。
Opus 5.5の新機能と変更点
Opus 5.5では、トークン単価の引き下げ、推論とツール利用の変更に加え、コーディングやコミュニケーションの改善が報告されています。Opus 5と比べ、コードレビューのワークフローを構築するチームにとって重要な変更は5つあります。
低いeffort設定でもコーディング性能が向上。 複数のステップを伴うコーディングタスクで、medium effortのOpus 5.5は、high effortのOpus 5と同等以上の成績を、約半分のトークンで達成しました。
トークン単価の引き下げ。 100万トークン当たりの入力料金は$5から$4に、出力料金は$25から$20に下がり、20%安くなります。キャッシュ読み取りは60%下がり、100万トークン当たり$0.20になります。同じ使用量なら料金は下がりますが、レビューを完了するまでのコストは、必要なトークン数と呼び出し回数によって変わります。
thinkingは常にadaptive。 Opus 5.5は、thinkingを明示的に有効または無効にするリクエストを拒否します。effortが、熟考の度合い、レイテンシ、コストを調整する主な手段になります。mediumから始め、lowとhighも併せて試すことが推奨されています。同じeffort設定でも、5.5はOpus 5より1ターン当たりの思考量が増える場合があり、特にx-highとmaxでその傾向があります。
ツール呼び出しの強制を廃止。 アプリケーションは、次の応答で特定のツールを必ず呼び出すよう要求できなくなります。ツールの結果に依存するワークフローでは、呼び出しが実際に行われたことを確認し、行われなかった場合に対処する必要があります。スキーマによる制約は引き続きツール呼び出しの引数に適用されますが、呼び出し自体を保証するものではありません。
デプロイの選択肢と安全対策の変更。 Fast modeが利用可能で、モデルの利用にデータ保持は必須ではありません。サイバーセキュリティ対策は維持され、Opus 5にはなかった生物学分野の分類器が追加されています。これらは統合時の検討事項であり、今回のベンチマークはその影響を測定していません。
テスト対象
CodeRabbitのレビューパイプライン内で、2つのOpus 5.5構成を本番のモデル構成と比較しました。この記事では、それぞれをStandardとMaxと呼びます。Standardは低めの推論effort設定を組み合わせ、Maxは高めの設定を組み合わせています。いずれもパイプライン全体の構成であり、単一のAPI effort値やAnthropicのデフォルト構成ではありません。
評価対象は、OSS Augustベンチマークの3構成すべてに共通する既知のバグパターン80件と、別のベンチマークであるSignalの難易度の高い13件です。
既知の問題の検出数、アクション可能な精度、検証・重複排除・フィルタリング後に報告されたコメント数を測定しました。精度は、対象の問題についてベンチマークの判定器が合格としたコメントの割合であり、開発者による採用率ではありません。変更行の外にある指摘も調べました。そこには、アクション可能コメントだけを数えた結果からは除外される有効な検出が含まれることがあります。
Opus 5.5がコードレビューにもたらすもの
以前のOpus 5の評価では、x-high構成のアクション可能コメントは本番ベースラインより精度が高い一方、既知のバグの検出は少なくなりました。今回の評価では、Opus 5.5の両構成がベースラインよりOSSの問題をわずかに多く検出し、精度はわずかに下がりました。ただし、テストセットと構成が異なるため、これは過去の結果との文脈上の比較であり、バージョン間の改善を直接測定したものではありません。
現在のレビュアーが見逃すバグを検出できる可能性がある
Opus 5.5を試す最大の理由は、検出するバグの組み合わせが変わることです。Standardは、ベースラインが見逃したオープンソースの問題11件を検出しましたが、ベースラインが検出した9件を見逃しました。総合スコアが改善しても、レビュアーを切り替えると、すり抜けるバグの種類は変わります。
具体的な不具合も見られました。Cal.comのベンチマークでは、並行して動くジョブが互いのリトライ回数の更新を上書きする可能性がありました。
// 修正前:両ジョブが retryCount = 0 を読み取る。
await prisma.workflowReminder.update({
  where: { id: reminder.id },
  data: { retryCount: reminder.retryCount + 1 },
});
// ジョブAが1を書き込み、ジョブBも1を書き込む。
// 2回増やそうとしても、カウンタの最終値は1。

// 修正後:データベースが現在の値に1を加える。
await prisma.workflowReminder.update({
  where: { id: reminder.id },
  data: { retryCount: { increment: 1 } },
});
// ジョブAが1に増やし、ジョブBが2に増やす。
// 両方の増分が保持される。
両Opus 5.5構成はこの競合を特定し、アトミックなインクリメントを使うよう提案しました。本番ベースラインは、この問題を見逃しました。
置き換えを検討するときは、現在のレビュアーだけが検出するバグと、新しいレビュアーだけが検出するバグを比較し、アプリケーションへの影響を評価してください。検出結果が異なるため、現在のレビュアーと並行して2つ目のレビュアーを試す価値があります。ただし、今回の実行では、両方を併用した場合の品質、コスト、コメント数は確認していません。
まずStandardから評価する
今回の実行では、Standardが評価の出発点として適しています。オープンソースのベンチマークでは、Maxより既知の問題をわずかに多く検出し、報告されたコメント数が少なく、アクション可能な精度も高くなりました。effortを上げても、一貫してより良いレビューが得られるわけではありません。
コメント数も重要です。誰かが指摘を確認する必要があるからです。件数はレビュー作業量の大まかな目安になります。バグ検出の増加と、それらの指摘を読んで調査するための作業を比較することが大切です。
| OSS August・共通80パターン | アクション可能な検出率 | アクション可能な精度 | レポートのコメント数 |
| 本番ベースライン | 49/80・61.3% | 39.3% | 116 |
| Opus 5.5 Standard | 51/80・63.8% | 38.6% | 127 |
| Opus 5.5 Max | 50/80・62.5% | 35.7% | 140 |
Maxは、OSSコメントのうち「minor」と分類した割合が高くなりましたが、そのラベルだけで指摘が無効または役に立たないとはいえません。
effortを上げると何が変わるかを試す
難易度の高いSignalのケースは、Maxを試す理由をより強く示しています。通常のアクション可能コメントで検出した問題は、13件中、Maxが10件、Standardが8件、ベースラインが5件でした。変更行の外にある指摘も含めると、両Opus構成は10件、ベースラインは7件になりました。
| Signal・13パターン | 既知の問題の検出数 | アクション可能な精度 | レポートのコメント数 | Major | Minor |
| 本番ベースライン | 5/13・38.5% | 29.4% | 17 | 11 | 6 |
| Opus 5.5 Standard | 8/13・61.5% | 66.7% | 21 | 14 | 7 |
| Opus 5.5 Max | 10/13・76.9% | 52.0% | 25 | 13 | 12 |
MajorとMinorは、報告されたコメントにモデルが付けた重要度のラベルです。異なるバグの件数を表すものではありません。
effortを上げても、バグの検出数が一貫して増えたわけではありません。変更行の外にあるコメントを含めてレビュー全体を見ると、StandardとMaxはどちらもSignalの13件中10件を検出しましたが、見逃した問題は異なりました。
チームにとって有用なのは、effortを上げることで通常の設定が見逃す重要なバグを検出できるか、代わりに他の価値ある検出を失わないかを確かめることです。そのコストを、経過時間、有用な指摘、見逃した問題、開発者が確認しなければならないコメントと比較してください。追加の検出が、チームにとって計算資源と人によるレビュー作業に見合う場合、その構成を使う価値があります。
利用コストはどのくらいか
レビューのコストは、トークン単価と使用量の両方で決まります。提供された料金ガイドでは、100万トークン当たりの入力料金は$4、出力料金は$20とされ、Opus 5の$5と$25から下がっています。キャッシュ読み取りは、100万トークン当たり$0.50から$0.20に下がります。これらは基本料金です。実際にデプロイするモデルとモードに適用される料金を使用してください。
評価チームは、テストしたすべての構成で、本番のモデル構成よりトークン使用量が増えたと報告しています。
| 本番ベースラインに対するトークン使用量の報告値 | OSS August | Signal |
| Opus 5.5 Standard | +49.2% | +40.6% |
| Opus 5.5 Max | +57.6% | +60.1% |
これらの数値はチームの実行サマリーに基づきます。入力トークンと出力トークンは区別されておらず、金額やレイテンシを示すものでもありません。また、トークン使用量の増加と、Opus 5に対する単価の引き下げでは、比較対象が異なります。
自分たちで評価する際は、リトライ、検証の呼び出し、フォールバックモデルを含め、レビュー完了までの入力、出力、キャッシュ読み取り、キャッシュ書き込みの使用量を分けて記録してください。思考もモデルのトークン上限を消費するため、見える回答が短くても、大量のトークンを使う場合があります。開発者が読む量を抑えるために簡潔な指摘を求めつつ、短いコメントなら安く済むと考えず、実際の使用量を確認してください。
請求額に加え、所要時間、有用な指摘、失われた検出、開発者が確認するコメント数も見てください。追加の検出が、自分たちの用途における計算コストと人によるレビュー作業に見合うなら、その構成を使う価値があります。
長時間にわたるコーディングタスク
今回の評価に携わったGowthamは、ポッドキャストで、個人のコーディングプロジェクトの目標をOpus 5.5に渡し、一晩作業させた経験を紹介しました。その成果は彼にもチームにも印象的で、長時間のコーディングタスクをこなす能力への評価をさらに高めました。この経験は、レビューの結果とは別の一面を示しています。モデルに十分な規模の目標と、それを進める時間を与えたときに、特に印象的な成果が見られました。
ビジュアルなゲーム開発と自動操作
また、Grand Theft Auto: San Andreasに着想を得た3つのプロジェクトでゲーム開発も試しました。Opus 5.5のPalmera Bay、AstraのWestline、Fable 5.1のSunhavenです。Opusのゲームは、細部まで作り込まれた環境と多彩なゲーム機能が印象的でしたが、今回のFableの例よりも開発に時間がかかりました。さらに、3つのゲームすべてを実演するボットをOpus 5.5に作らせました。ボットはPalmera Bayではスタント走行と戦闘を組み合わせ、Westlineでは海岸沿いのミッションを完了し、Sunhavenではストリートレースに挑戦してから警察の追跡を逃れました。動画では、これらのボットによる実行の一部を紹介します。ボットは実行中のゲーム状態を読み取り、キーボードとマウスの入力を送ります。モデルがゲーム操作のロジックを書く、コーディングと自動化の実践例です。
結論
Opus 5.5が特に印象的だったのは、より難しい作業に取り組む場面でした。小規模ながら難易度の高いSignalベンチマークでは、検出率と精度がともに向上しました。また、実際に試したコーディングでは、何時間も続くタスクから十分な成果が得られました。このコーディングでの手応えはレビューベンチマークとは別のものですが、複雑なタスクを最後まで進めるモデルの能力を肯定的に評価する理由になっています。
コードレビューでの改善は、より限定的でした。対象が広いオープンソースのベンチマークでは、検出率の上昇はわずかでした。価値ある新しい検出がある一方で、本番レビュアーが検出したバグをOpusが見逃すこともありました。全体的なバランスはStandardが優れていた一方、Maxに追加のeffortを与えた場合のレビュー全体の結果にはばらつきがありました。
トレードオフは、その成果を得るまでにモデルが行う作業量です。レビューの実行では、トークン使用量とコメント数が増えました。より細かく作り込まれたコーディングのデモにも、より長い時間がかかりました。難しいタスクに取り組むOpus 5.5の能力は印象的です。その効率性についてはまだ結論が出ていないため、トークン単価の引き下げが実際に本番レビューのコスト削減につながるかを、各チームで検証する必要があります。